JVM总结
一、JVM概述
定义
Java Virtual Machine,JAVA程序的运行环境(JAVA二进制字节码的运行环境)
好处
一次编写,到处运行(多系统运行)
自动内存管理,垃圾回收机制
数组下标越界检查
比较
JVM、JRE、JDK的意义和区别
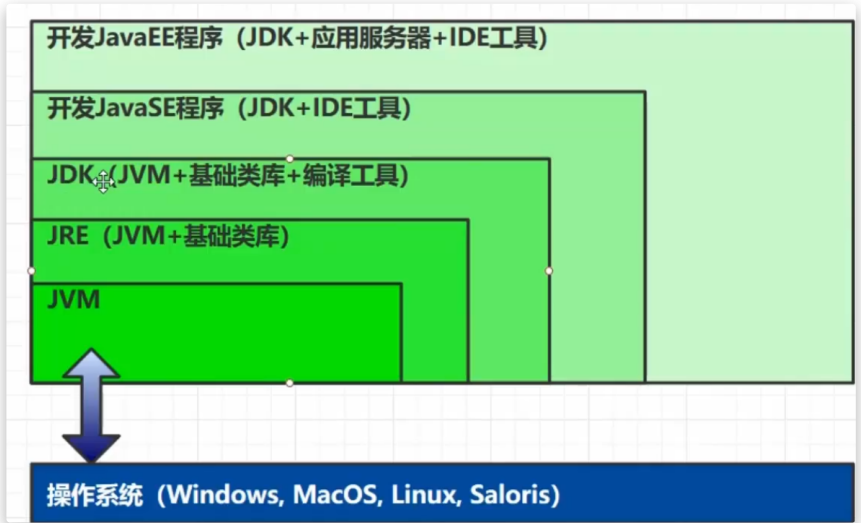
JVM、JRE、JDK的意义与区别
二、JVM内存结构
整体架构
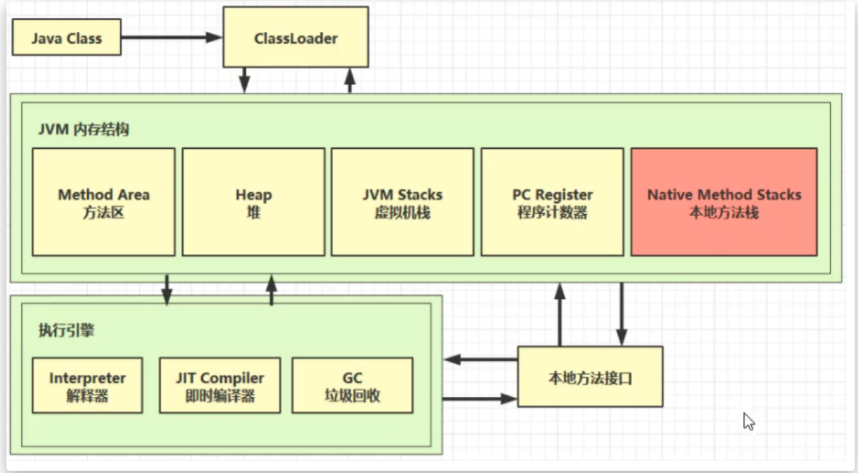
JVM结构图
2.1、程序计数器
作用
用于保存JVM中下一条所要执行的指令的地址
JAVA代码执行流程:
JAVA代码 => 编译后得到二进制字节码(JVM指令)=> 解释器 => 机器码(0101) => CPU执行
其中程序计数器保存下一条JVM指令,当上一个指令完成时继续执行代码
特点
- 线程私有
- CPU会为每个线程分配时间片,当当前线程的时间片使用完以后,CPU就会去执行另一个线程中的代码
- 程序计数器是每个线程所私有的,当另一个线程的时间片用完,又返回来执行当前线程的代码时,通 过程序计数器可以知道应该执行哪一句指令
- 不会存在内存溢出
2.2、虚拟机栈
定义
- 每个线程运行需要的内存空间,称为虚拟机栈
- 每个栈由多个栈帧组成,对应着每次调用方法时所占用的内存
- 每个线程只能有一个活动栈帧,对应着当前正在执行的方法
问题辨析
- 垃圾回收是否涉及栈内存?
- 不需要。因为虚拟机栈中是由一个个栈帧组成的,在方法执行完毕后,对应的栈帧就会被弹出栈。所 以无需通过垃圾回收机制去回收内存。
- 栈内存的分配越大越好吗?
- 不是。因为物理内存是一定的,栈内存越大,可以支持更多的递归调用,但是可执行的线程数就会越少。
- 方法内的局部变量是否是线程安全的?
- 如果方法内局部变量没有逃离方法的作用范围,则是线程安全的
- 如果如果局部变量引用了对象,并逃离了方法的作用范围,则需要考虑线程安全问题(逃逸分析)
- 内存溢出(Java.lang.stackOverflowError)可能存在的原因?
- 虚拟机栈中,栈帧过多(无限递归)
- 每个栈帧所占用过大
- 线程运行诊断(CPU占用过高)
- Linux环境下运行某些程序的时候,可能导致CPU的占用过高,这时需要定位占用CPU过高的线程
- top命令,查看是哪个进程占用CPU过高
- ps H -eo pid, tid(线程id), %cpu | grep 刚才通过top查到的进程号 通过ps命令进一步查看是 哪个线程占用CPU过高
- jstack 进程id 通过查看进程中的线程的nid,刚才通过ps命令看到的tid来对比定位,注意jstack查找 出的线程id是16进制的,需要转换
- Linux环境下运行某些程序的时候,可能导致CPU的占用过高,这时需要定位占用CPU过高的线程
2.3、本地方法栈
说明
一些带有native关键字的方法就是需要JAVA去调用本地的C或者C++方法,因为JAVA有时候没法直接和操作 系统底层交互,所以需要用到本地方法
2.4、堆
定义
通过new关键字创建的对象都会被放在堆内存
特点
- 所有线程共享,堆内存中的对象都需要考虑线程安全问题
- 存在垃圾回收机制
问题辨析
- 堆内存溢出(java.lang.OutofMemoryError :java heap space.)诊断工具
- jps
- jmap
- jconsole
- jvirsalvm
2.5、方法区
结构
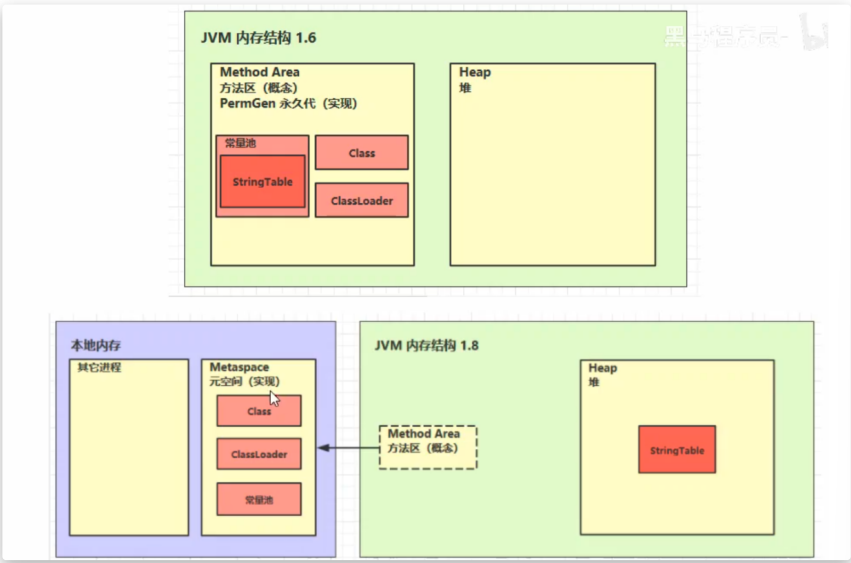
方法区结构
说明
- 1.6以前方法区存在于堆中,会导致永久代内存溢出
- 1.8以后方法区存在于元空间中(元空间位于本地内存中),会导致元空间内存溢出
常量池
二进制字节码的组成:类的基本信息、常量池、类的方法定义(包含了虚拟机指令)
通过反编译来查看类的信息
- 获得对应类的.class文件
- 在JDK对应的bin目录下运行cmd,也可以在IDEA控制台输入
- 输入 javac 对应类的绝对路径
C:\JAVA\JDK8.0\bin>javac C:\study\src\com\nyima\JVM\day01\Main.java输入完成后,对应的目录下就会出现类的.class文件
在控制台输入 javap -v 类的绝对路径
javap -v C:\study\src\com\nyima\JVM\day01\Main.class然后能在控制台看到反编译以后类的信息了
包括类的基本信息、常量池
虚拟机中执行编译的方法(框内的是真正编译执行的内容,#号的内容需要在常量池中查找)
运行时常量池
- 常量池
- 就是一张表(如上图中的constant pool),虚拟机指令根据这张常量表找到要执行的类名、方法 名、参数类型、字面量信息
- 运行时常量池
- 常量池是.class文件中的,当该类被加载以后,它的常量池信息就会放入运行时常量池,*并把里面的符号地址变为真实地址
常量池与串池的关系
stringtable、stringpool、串池、字符串常量池,这四个是一个东西。
但是跟常量池不是一个东西!串池在堆中
跟常量池是包含关系,跟运行时常量池是互斥关系。
串池(StringTable)
特点
常量池中的字符串仅是符号,只有在被用到时才会转化为对象
利用串池的机制,来避免重复创建字符串对象
字符串变量拼接的原理是StringBuilder
字符串常量拼接的原理是编译器优化
可以使用intern方法,主动将串池中还没有的字符串对象放入串池中
结构为HashTable (数组 + 链表)
注意:无论是串池还是堆里面的字符串,都是对象
注意:字符串对象的创建都是懒惰的,只有当运行到那一行字符串且在串池中不存在的时候(如 ldc #2) 时,该字符串才会被创建并放入串池中。
注意:通过拼接的方式来创建字符串的过程
只能在运行期确定它的值,所以需要使用StringBuilder来创建
StringBuilder().append(“a”).append(“b”).toString()
最后的toString方法的返回值是一个新的字符串,但字符串的值和拼接的字符串一致,但是是两个不同的字符串,一个存在于串池之中,一个存在于堆内存之中
intern方法 1.8
调用字符串对象的intern方法,会将该字符串对象尝试放入到串池中
- 如果串池中没有该字符串对象,则放入成功
- 如果有该字符串对象,则放入失败
无论放入是否成功,都会返回串池中的字符串对象
注意:此时如果调用intern方法成功,堆内存与串池中的字符串对象是同一个对象;
如果失败,则不是同一个 对象
intern方法 1.6
调用字符串对象的intern方法,会将该字符串对象尝试放入到串池中
- 如果串池中没有该字符串对象,会将该字符串对象复制一份,再放入到串池中
- 如果有该字符串对象,则放入失败
无论放入是否成功,都会返回串池中的字符串对象
注意:此时无论调用intern方法成功与否,串池中的字符串对象和堆内存中的字符串对象都不是同一个对象
StringTable 垃圾回收
StringTable在内存紧张时,会发生垃圾回收
StringTable调优
- 因为StringTable是由HashTable实现的,所以可以适当增加HashTable桶的个数,来减少字符串放入串池所需要的时间
-XX:StringTableSize=xxxx考虑是否需要将字符串对象入池
可以通过intern方法减少重复入池
2.6、直接内存
- 属于操作系统,常见于NIO操作时,用于数据缓冲区
- 分配回收成本较高,但读写性能高
- 不受JVM内存回收管理
文件读写流程
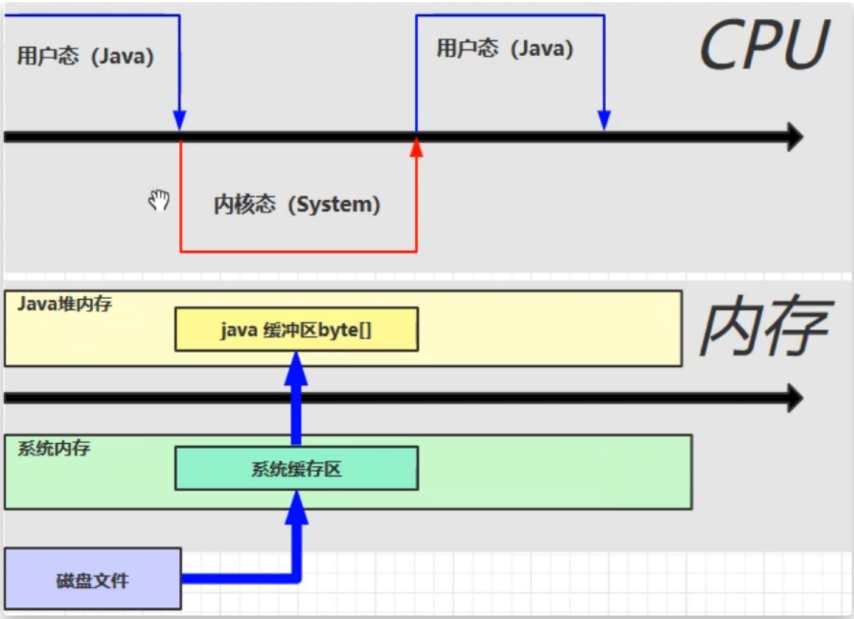
文件读写流程
使用了DirectBuffer
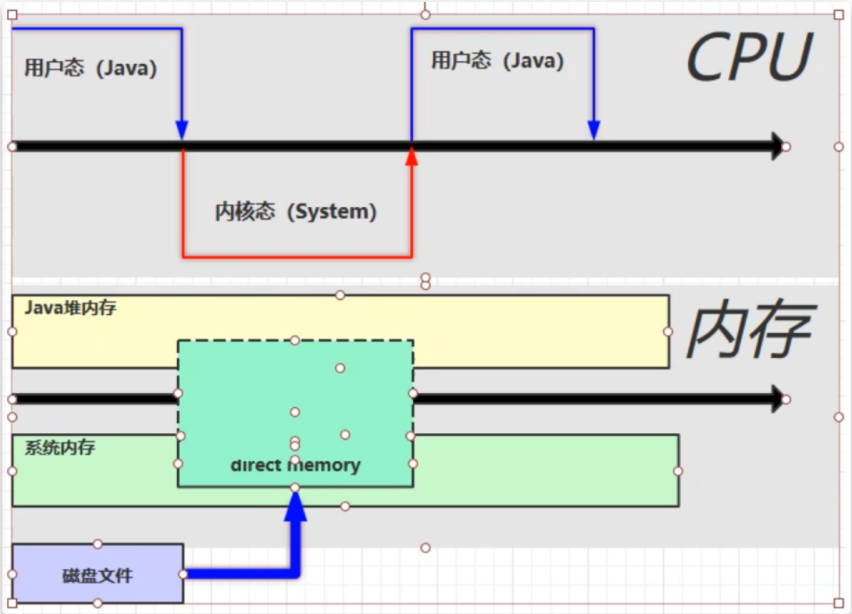
文件读写流程
直接内存是操作系统和Java代码都可以访问的一块区域,无需将代码从系统内存复制到Java堆内存,从而提高 了效率
释放原理
直接内存的回收不是通过JVM的垃圾回收来释放的,而是通过unsafe.freeMemory来手动释放
//通过ByteBuffer申请1M的直接内存
ByteBuffer byteBuffer = ByteBuffer.allocateDirect(_1M);
申请直接内存,但JVM并不能回收直接内存中的内容,它是如何实现回收的呢?
allocateDirect的实现
public static ByteBuffer allocateDirect(int capacity) {
 return new DirectByteBuffer(capacity);
}
DirectByteBuffer类
DirectByteBuffer(int cap) { // package-private

            super(-1, 0, cap, cap);
            boolean pa = VM.isDirectMemoryPageAligned();
            int ps = Bits.pageSize();
            long size = Math.max(1L, (long)cap + (pa ? ps : 0));
            Bits.reserveMemory(size, cap);
            long base = 0;
            try {
                base = unsafe.allocateMemory(size); //申请内存
            } catch (OutOfMemoryError x) {
                Bits.unreserveMemory(size, cap);
                throw x;
            }
            unsafe.setMemory(base, size, (byte) 0);
            if (pa && (base % ps != 0)) {
                // Round up to page boundary
                address = base + ps - (base & (ps - 1));
            } else {
                address = base;
            }
            //通过虚引用,来实现直接内存的释放,this为虚引
            cleaner = Cleaner.create(this, new Deallocator(base, size, cap));
            att = null;
        }
这里调用了一个Cleaner的create方法,且后台线程还会对虚引用的对象监测
如果虚引用的实际对象(这里是DirectByteBuffer)被回收以后,就会调用Cleaner的clean方法,来清除直接内存中占用的内存
public void clean() {
            if (remove(this)) {
                try {
                    this.thunk.run(); //调用run方法
                } catch (final Throwable var2) {
                    AccessController.doPrivileged(new PrivilegedAction<Void>() {
                        public Void run() {
                            if (System.err != null) {
                                (new Error("Cleaner terminated abnormally", var2)).printStackTrace();
                            }
                            System.exit(1);
                            return null;
                        }
                    });
                }

    }
}
对应对象的run方法
public void run() {
           if (address == 0) {
               // Paranoia
               return;
           }
           unsafe.freeMemory(address); //释放直接内存中占用的内存
           address = 0;
           Bits.unreserveMemory(size, capacity);
       }
直接内存的回收机制总结
- 使用了Unsafe类来完成直接内存的分配回收,回收需要主动调用freeMemory方法
- ByteBuffer的实现内部使用了Cleaner(虚引用)来检测ByteBuffer。一旦ByteBuffer被垃圾回收,那么 会由ReferenceHandler来调用Cleaner的clean方法调用freeMemory来释放内存
三、JVM垃圾回收机制
1、如何判断对象可以被回收?
引用计数法
若对象被引用则该对象的计数加1
弊端:循环引用时,两个对象的计数都为1,导致两个对象都无法被释放
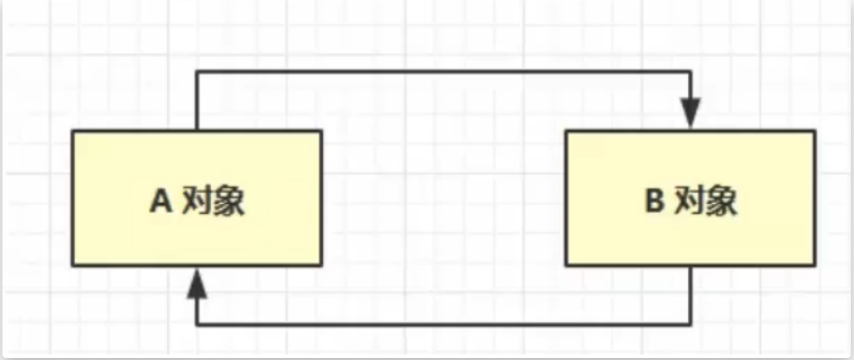
相互引用导致无法释放
可达性分析算法
JVM中的垃圾回收器通过可达性分析来探索所有存活的对象
扫描堆中的对象,看能否沿着GC Root对象为起点的引用链找到该对象,如果找不到,则表示可以回收
可以作为
GC Root的对象
- 虚拟机栈(栈帧中的本地变量表)中引用的对象。
- 方法区中类静态属性引用的对象
- 方法区中常量引用的对象
- 本地方法栈中JNI(即一般说的Native方法)引用的对象
五种引用
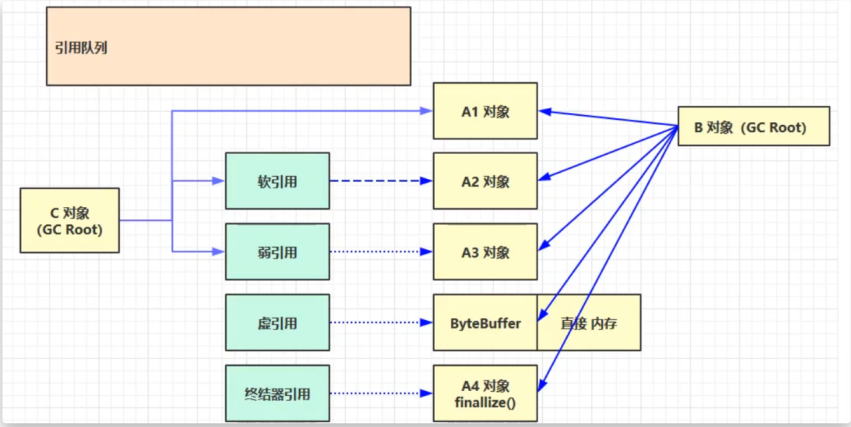
五种引用说明
强引用
只有GC Root都不引用该对象时,才会回收强引用对象
如上图B、C对象都不引用A1对象时,A1对象才会被回收
软引用
当GC Root指向软引用对象时,在内存不足时,会回收软引用所引用的对象
如上图如果B对象不再引用A2对象且内存不足时,软引用所引用的A2对象就会被回收
- 软引用的使用
public class Demo1 {
            public static void main(String[] args) {
                final int _4M = 4*1024*1024;
				//使用软引用对象 list和SoftReference是强引用,而SoftReference和byte数组则是软引用
                List<SoftReference<byte[]>> list = new ArrayList<>();
                SoftReference<byte[]> ref= new SoftReference<>(new byte[_4M]);
            }
}如果在垃圾回收时发现内存不足,在回收软引用所指向的对象时,软引用本身不会被清理
如果想要清理软引用,需要使用引用队列
public class Demo1 {
            public static void main(String[] args) {
                final int _4M = 4*1024*1024;
                //使用引用队列,用于移除引用为空的软引用对象
                ReferenceQueue<byte[]> queue = new ReferenceQueue<>();
                //使用软引用对象 list和SoftReference是强引用,而SoftReference和byte数组则是软引用
                List<SoftReference<byte[]>> list = new ArrayList<>();
                SoftReference<byte[]> ref= new SoftReference<>(new byte[_4M]);
                //遍历引用队列,如果有元素,则移除
                Reference<? extends byte[]> poll = queue.poll();
                while(poll != null) {
                //引用队列不为空,则从集合中移除该元素
                    list.remove(poll);
                //移动到引用队列中的下一个元素
                    poll = queue.poll();
                }
            }
}- 大概思路为:查看引用队列中有无软引用,如果有,则将该软引用从存放它的集合中移除(这里为一个list集合)
弱引用
只有弱引用引用该对象时,在垃圾回收时,无论内存是否充足,都会回收弱引用所引用的对象
如上图如果B对象不再引用A3对象,则A3对象会被回收
弱引用的使用和软引用类似,只是将 SoftReference 换为了 WeakReference
虚引用
当虚引用对象所引用的对象被回收以后,虚引用对象就会被放入引用队列中,调用虚引用的方法
- 虚引用的一个体现是释放直接内存所分配的内存,当引用的对象ByteBuffer被垃圾回收以后,虚引用对象 Cleaner就会被放入引用队列中,然后调用Cleaner的clean方法来释放直接内存
- 如上图,B对象不再引用ByteBuffer对象,ByteBuffer就会被回收。但是直接内存中的内存还未被回收。 这时需要将虚引用对象Cleaner放入引用队列中,然后调用它的clean方法来释放直接内存
终结器引用
所有的类都继承自Object类,Object类有一个finalize方法。当某个对象不再被其他的对象所引用时,会先将 终结器引用对象放入引用队列中,然后根据终结器引用对象找到它所引用的对象,然后调用该对象的finalize 方法。调用以后,该对象就可以被垃圾回收了
如上图,B对象不再引用A4对象。这是终结器对象就会被放入引用队列中,引用队列会根据它,找到它所 引用的对象。然后调用被引用对象的finalize方法。调用以后,该对象就可以被垃圾回收了
引用队列
软引用和弱引用可以配合引用队列
在弱引用和虚引用所引用的对象被回收以后,会将这些引用放入引用队列中,方便一起回收这些软/ 弱引用对象
虚引用和终结器引用必须配合引用队列
2、垃圾回收算法
标记—清除算法
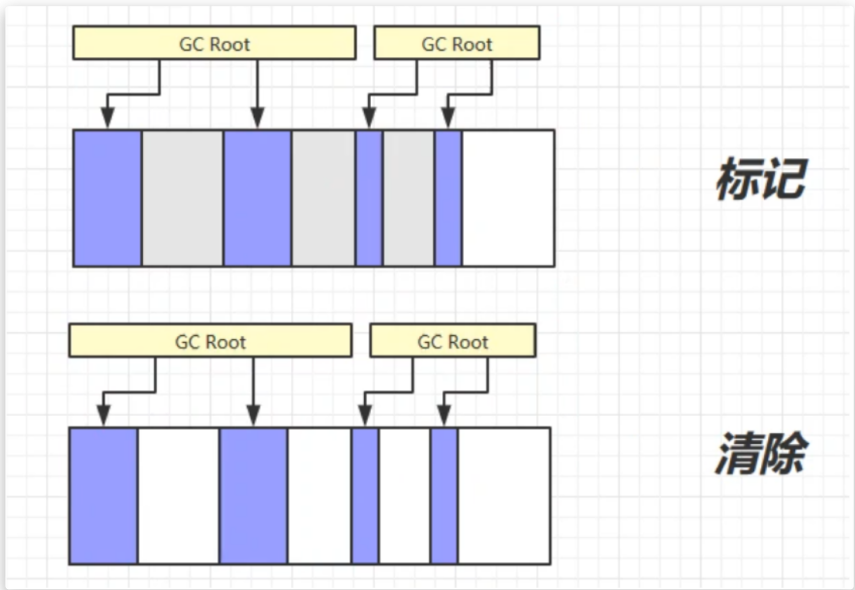
标记清除算法图解
定义
标记清除算法顾名思义,是指在虚拟机执行垃圾回收的过程中,先采用标记算法确定可回收对象,然后 垃圾收集器根据标识清除相应的内容,给堆内存腾出相应的空间
缺点
容易产生大量的内存碎片,可能无法满足大对象的内存分配,一旦导致无法分配对象,那就会导致jvm 启动gc,一旦启动gc,我们的应用程序就会暂停,这就导致应用的响应速度变慢
标记—整理算法
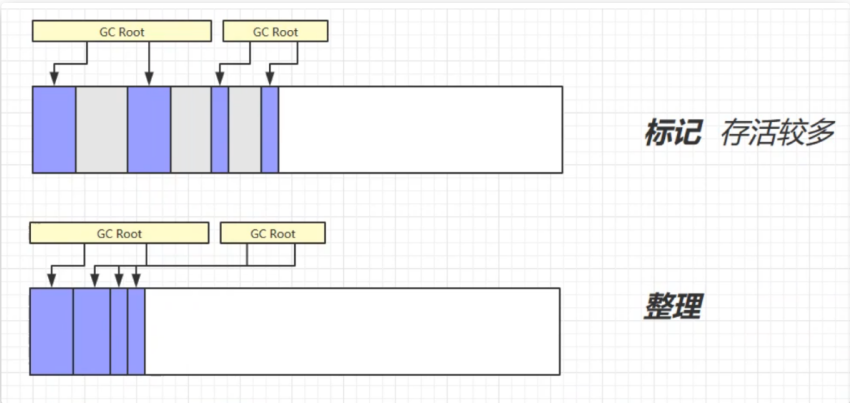
标记整理算法图解
定义
标记-整理会将不被GC Root引用的对象回收,清除其占用的内存空间。然后整理剩余的对象,可以有效避免因内存碎片而导致的问题,但是因为整体需要消耗一定的时间,所以效率较低
复制算法
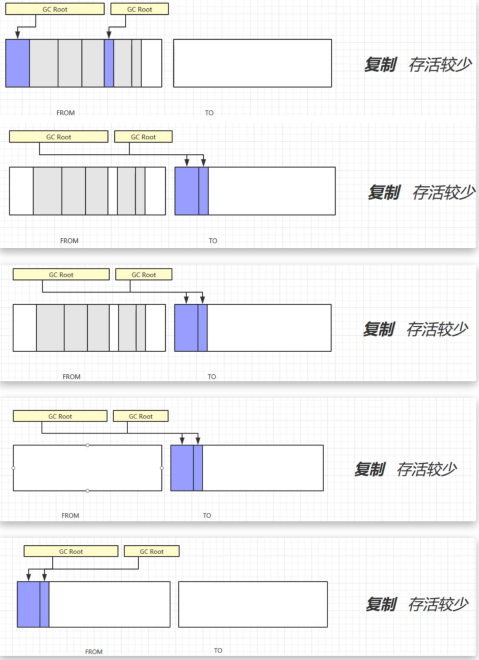
复制算法图解
定义
将内存分为等大小的两个区域,FROM和TO(TO中为空)。先将被GC Root引用的对象从FROM放入TO 中,再回收不被GC Root引用的对象。然后交换FROM和TO。这样也可以避免内存碎片的问题,但是会占用 双倍的内存空间。
3、分代回收
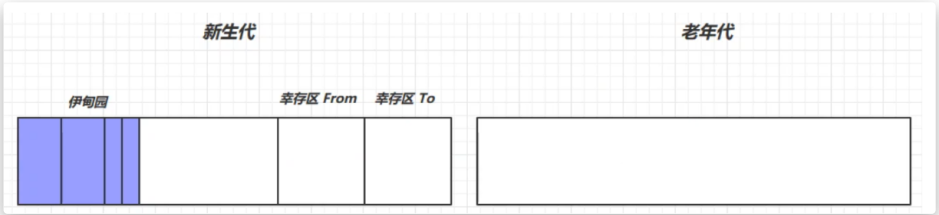
分代回收图解
回收流程
1、新创建的对象都被放在了新生代的伊甸园中
2、当伊甸园中的内存不足时,就会进行一次垃圾回收,这时的回收叫做 Minor GC
Minor GC 会将伊甸园和幸存区FROM存活的对象先复制到幸存区 TO中, 并让其寿命加1,再交换两个幸存区
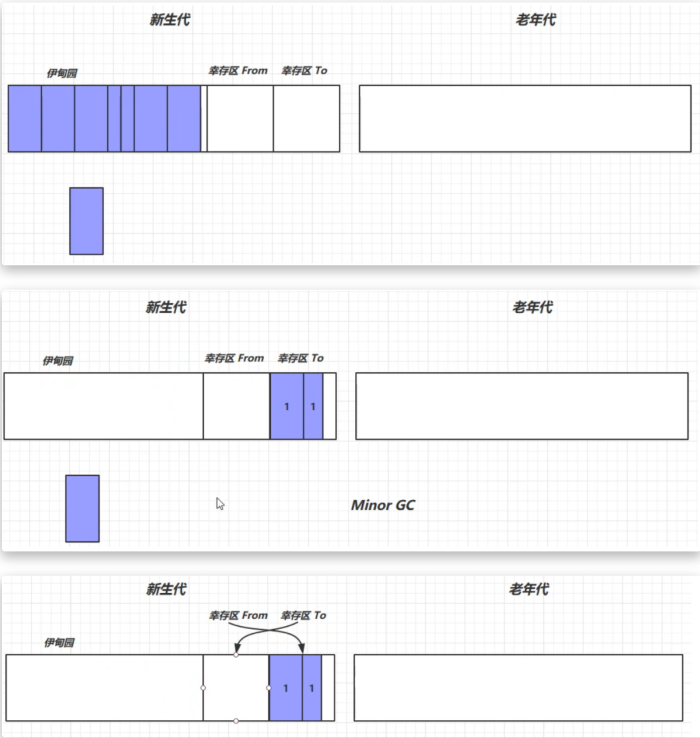
Minor GC 图解
3、再次创建对象,若新生代的伊甸园又满了,则会再次触发 Minor GC(会触发 stop the world, 暂停其他用 户线程,只让垃圾回收线程工作),这时不仅会回收伊甸园中的垃圾,还会回收幸存区中的垃圾,再将活跃对象复制到幸存区TO中。回收以后会交换两个幸存区,并让幸存区中的对象寿命加1
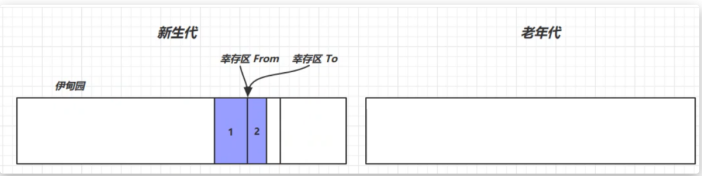
4、如果幸存区中的对象的寿命超过某个阈值(最大为15,4bit),就会被放入老年代中
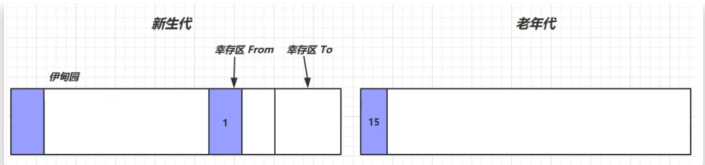
对象晋升老年代
5、如果新生代老年代中的内存都满了,就会先触发Minor GC,再触发Full GC,扫描新生代和老年代中所有不再使用的对象并回收
相关参数
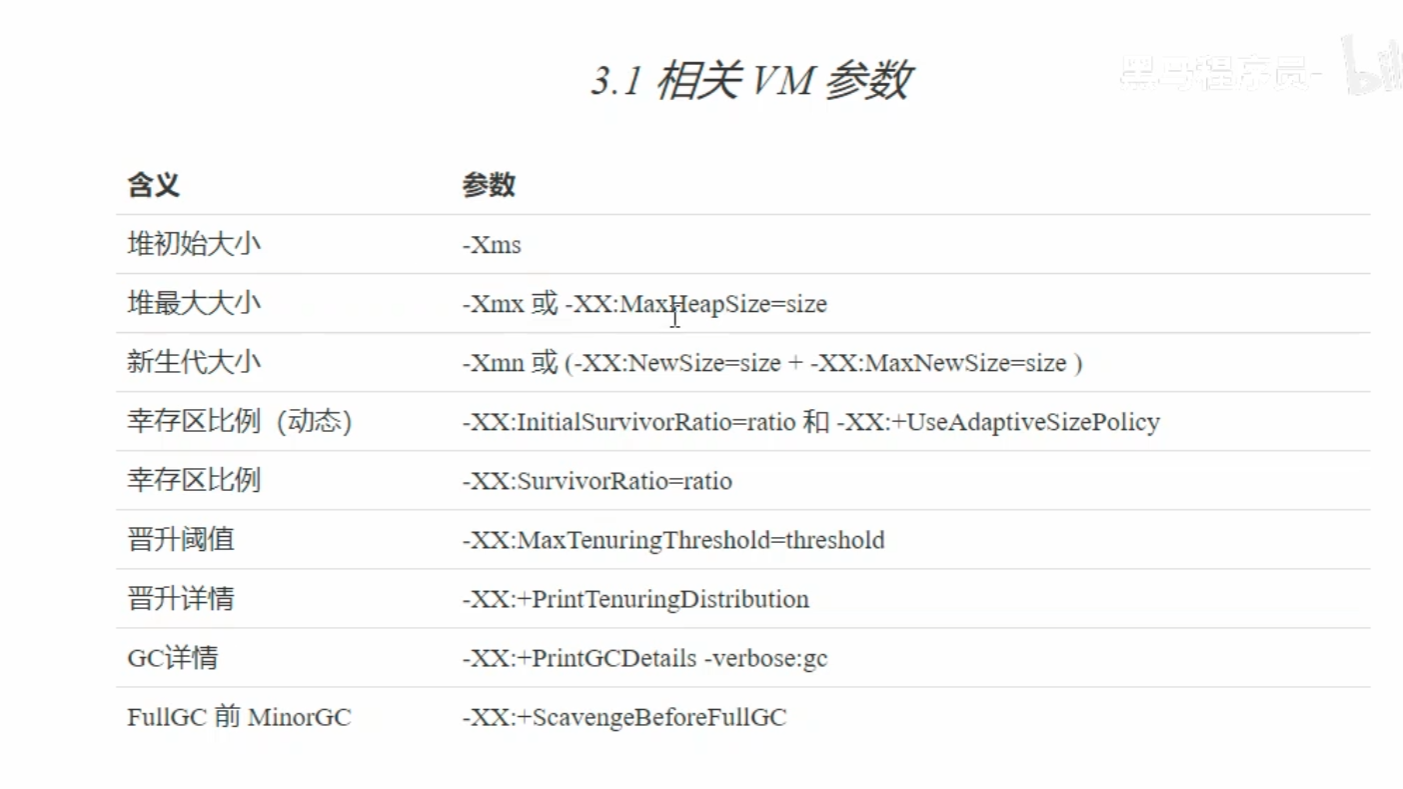
相关JVM参数
GC分析
大对象处理策略
当遇到一个较大的对象时,就算新生代的伊甸园为空,也无法容纳该对象时,会将该对象直接晋升为老年代
线程内存溢出
某个线程的内存溢出了而抛异常(out of memory),不会让其他的线程结束运行
这是因为当一个线程抛出OOM异常后,它所占据的内存资源会全部被释放掉,从而不会影响其他线程的运行,进程依然正常
4、垃圾回收器
相关概念
并行收集:指多条垃圾收集线程并行工作,但此时用户线程仍处于等待状态。
并发收集:指用户线程与垃圾收集线程同时工作(不一定是并行的可能会交替执行)。用户程序在继续运行, 而垃圾收集程序运行在另一个CPU上
吞吐量:即CPU用于运行用户代码的时间与CPU总消耗时间的比值
(吞吐量 = 运行用户代码时间 / ( 运行用户 代码时间 + 垃圾收集时间 ))
例如:虚拟机共运行100分钟,垃圾收集器花掉1分钟,那么吞吐量 就是99%
串行:
- 单线程
- 内存较小,一般用于个人电脑(CPU核数较少)
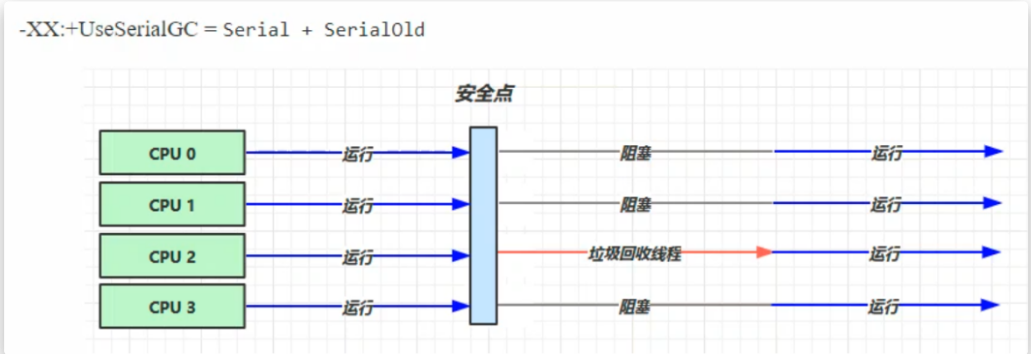
串行图解
安全点:让其他线程都在这个点停下来,以免垃圾回收时移动对象地址,使得其他线程找不到被移动的对象 因为是串行的,所以只有一个垃圾回收线程。且在该线程执行回收工作时,其他线程进入阻塞状态
相关收集器
Serial 收集器
Serial收集器是最基本的、发展历史最悠久的收集器
特点
单线程、简单高效(与其他收集器的单线程相比),采用复制算法。对于限定单个CPU的环境来说, Serial收集器由于没有线程交互的开销,专心做垃圾收集自然可以获得最高的单线程手机效率。收集器进行垃 圾回收时,必须暂停其他所有的工作线程,直到它结束(Stop The World)
ParNew 收集器
ParNew收集器其实就是Serial收集器的多线程版本
特点
多线程、ParNew收集器默认开启的收集线程数与CPU的数量相同,在CPU非常多的环境中,可以使 用
-XX:ParallelGCThreads参数来限制垃圾收集的线程数。和Serial收集器一样存在Stop The World问题
Serial Old 收集器
Serial Old是Serial收集器的老年代版本
特点
同样是单线程收集器,采用标记-整理算法
吞吐量优先
- 说明
- 多线程
- 堆内存较大,多核CPU
- 单位时间内,STW(stop the world,停掉其他所有工作线程)时间最短
- JDK1.8默认使用的垃圾回收器
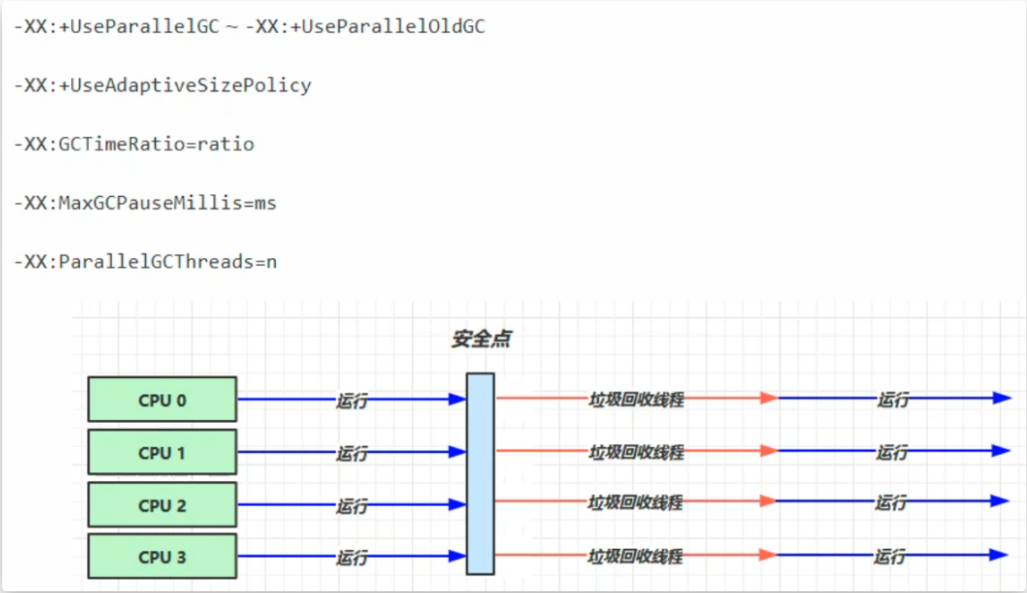
运行流程图
Parallel Scavenge 收集器
与吞吐量关系密切,故也称为吞吐量优先收集器
特点
属于新生代收集器也是采用复制算法的收集器(用到了新生代的幸存区),又是并行的多线程收集器 (与ParNew收集器类似)
该收集器的目标是达到一个可控制的吞吐量。还有一个值得关注的点是:GC自适应调节策略(与ParNew收 集器最重要的一个区别)
GC自适应调节策略:Parallel Scavenge收集器可设置-XX:+UseAdptiveSizePolicy参数。当开关打开时不需 要手动指定新生代的大小(-Xmn)、Eden与Survivor区的比例(-XX:SurvivorRation)、晋升老年代的对象 年龄(-XX:PretenureSizeThreshold)等,虚拟机会根据系统的运行状况收集性能监控信息,动态设置这些参数以提供最优的停顿时间和最高的吞吐量,这种调节方式称为GC的自适应调节策略。
Parallel Scavenge收集器使用两个参数控制吞吐量:
- XX:MaxGCPauseMillis 控制最大的垃圾收集停顿时间
- XX:GCRatio 直接设置吞吐量的大小
Parallel Old 收集器
是Parallel Scavenge收集器的老年代版本
特点
多线程,采用标记-整理算法(老年代没有幸存区)
响应时间优先
- 说明
- 多线程
- 堆内存较大,多核CPU
- 尽可能让单次STW时间变短(尽量不影响其他线程运行)
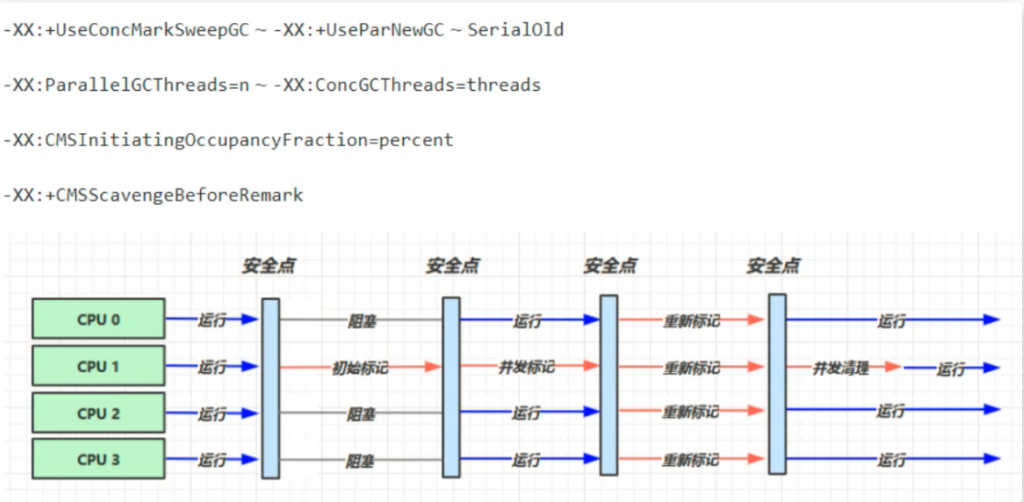
运行流程图
CMS 收集器说明
Concurrent Mark Sweep,一种以获取最短回收停顿时间为目标的老年代收集器
特点
基于标记-清除算法实现。并发收集、低停顿,但是会产生内存碎片
应用场景
适用于注重服务的响应速度,希望系统停顿时间最短,给用户带来更好的体验等场景下。如web程 序、b/s服务
CMS收集器的运行过程分为下列4步:
初始标记:标记GC Roots能直接到的对象。速度很快但是仍存在Stop The World问题
并发标记:进行GC Roots Tracing 的过程,找出存活对象且用户线程可并发执行
重新标记:为了修正并发标记期间因用户程序继续运行而导致标记产生变动的那一部分对象的标记记录。仍然存在Stop The World问题
并发清除:对标记的对象进行清除回收CMS收集器的内存回收过程是与用户线程一起并发执行的
CMS收集器的内存回收过程是与用户线程一起并发执行的
G1
定义
Garbage First
JDK 9以后默认使用,而且替代了CMS 收集器
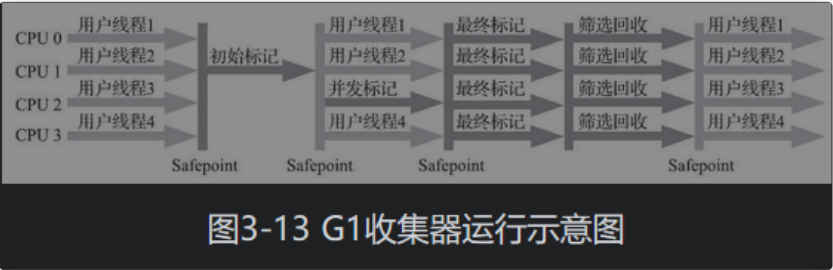
适用场景和特点
- 同时注重吞吐量和低延迟(响应时间)
- 超大堆内存(内存大的),会将堆内存划分为多个大小相等的区域
- 整体上是标记-整理算法,两个区域之间是复制算法
相关参数
JDK8 并不是默认开启的,所需要参数开启
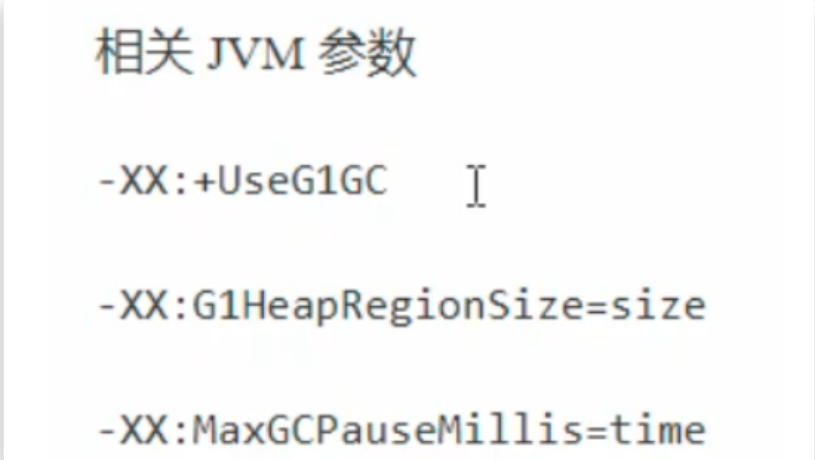
G1垃圾回收器相关参数
G1垃圾回收步骤
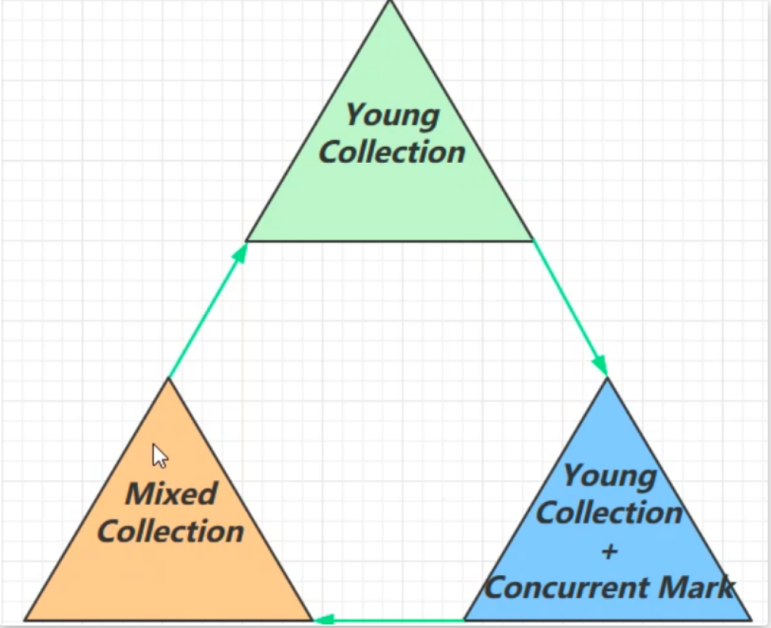
G1垃圾回收步骤
新生代伊甸园垃圾回收—–>内存不足,新生代回收+并发标记
—–>回收新生代伊甸园、幸存区、老年代内存 ——>新生代伊甸园垃圾回收(重新开始)
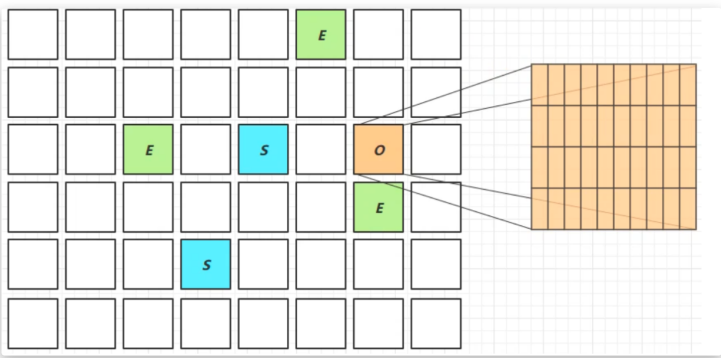
Young Collection
分区算法region
分代是按对象的生命周期划分,分区则是将堆空间划分连续几个不同小区间,每一个小区间独立回收,可以控制一次回收多少个小区间,方便控制 GC 产生的停顿时间
E:伊甸园 S:幸存区 O:老年代
- 会产生STW
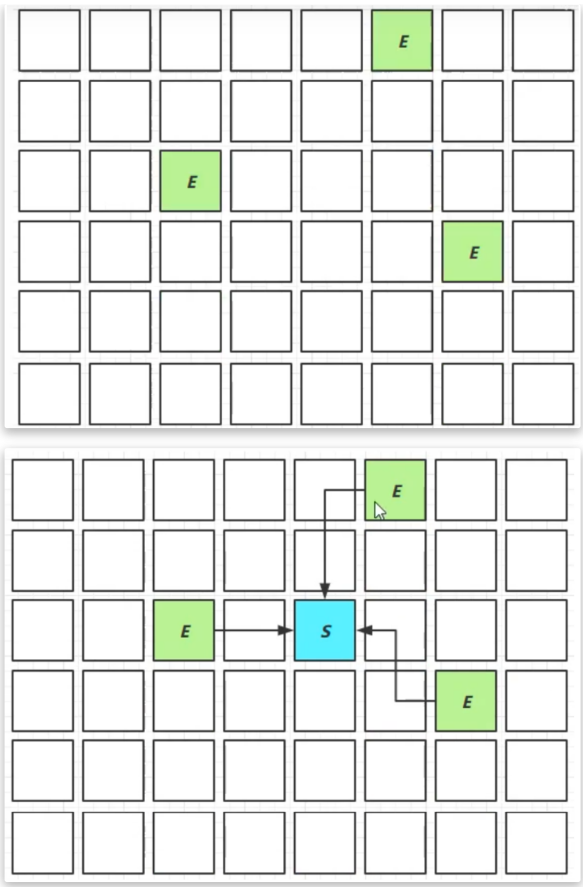
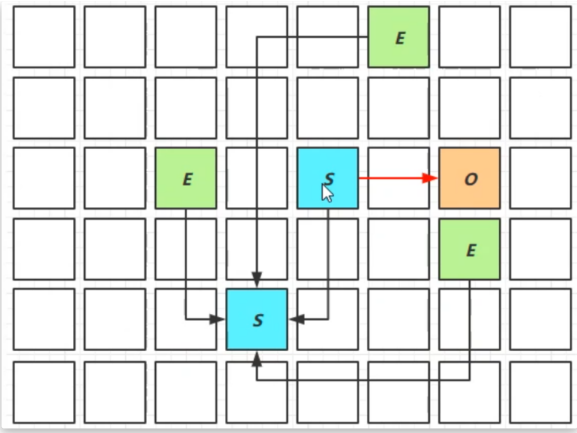
Young Collection + CM
CM:并发标记
- 在 Young GC 时会对 GC Root 进行初始标记
- 在老年代占用堆内存的比例达到阈值时,对进行并发标记(不会STW),阈值可以根据用户来进行设定
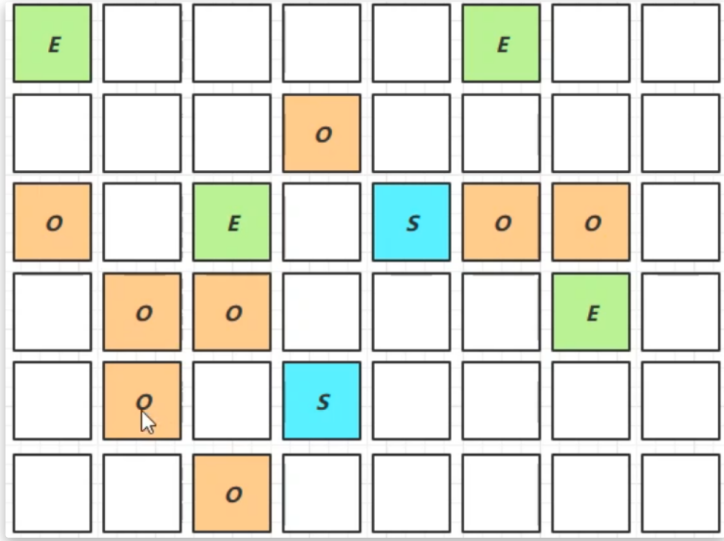
Mixed Collection
会对E S O 进行全面的回收
- 最终标记
- 拷贝存活
-XX:MaxGCPauseMills:xxx 用于指定最长的停顿时间
问:为什么有的老年代被拷贝了,有的没拷贝?
因为指定了最大停顿时间,如果对所有老年代都进行回收,耗时可能过高。为了保证时间不超过设定的停顿时间,会回收最有价值的老年代(回收后能够得到更多内存)
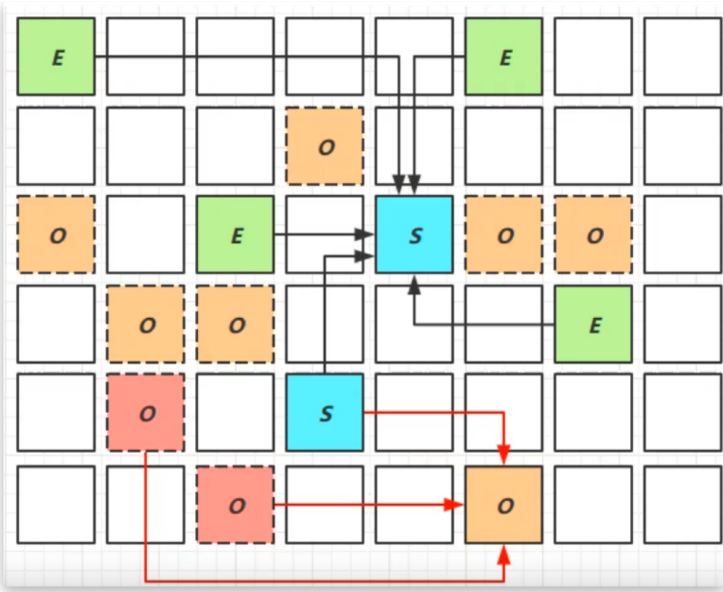
Full GC
G1在老年代内存不足时(老年代所占内存超过阈值)
- 如果垃圾产生速度慢于垃圾回收速度,不会触发Full GC,还是并发地进行清理
- 如果垃圾产生速度快于垃圾回收速度,便会触发Full GC
Young Collection 跨代引用
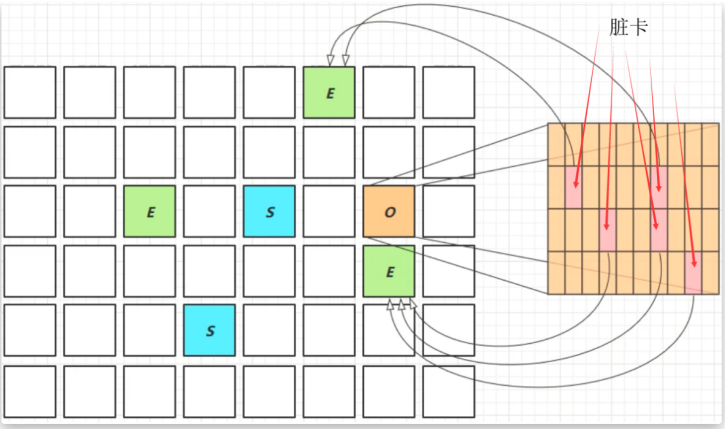
- 新生代回收的跨代引用(老年代引用新生代)问题
- 卡表与Remembered Set
- Remembered Set 存在于E中,用于保存新生代对象对应的脏卡
- 脏卡:O被划分为多个区域(一个区域512K),如果该区域引用了新生代对象,则该区域被称 为脏卡
- Remembered Set 存在于E中,用于保存新生代对象对应的脏卡
- 在引用变更时通过post-write barried + dirty card queue
- concurrent refinement threads 更新 Remembered Set
Remark
重新标记阶段
在垃圾回收时,收集器处理对象的过程中 :
黑色:已被处理,需要保留的
灰色:正在处理中的
白色:还未处理的
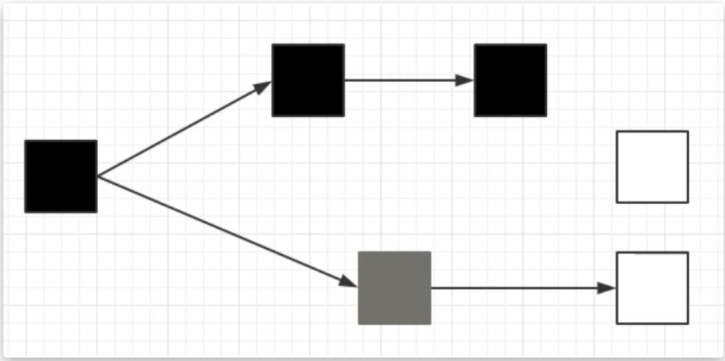
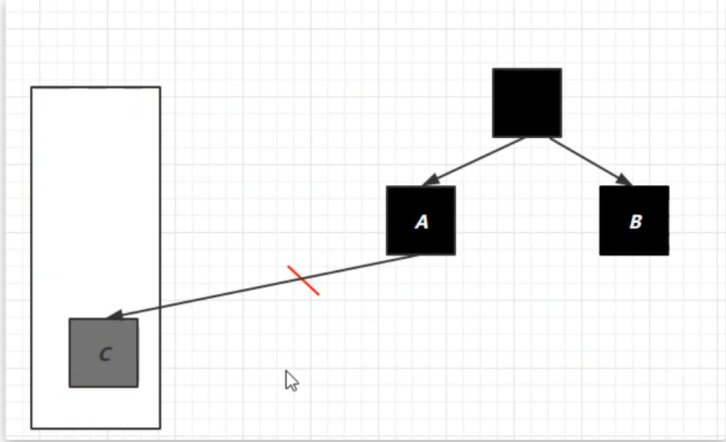
但是在并发标记过程中,有可能A被处理了以后未引用C,但该处理过程还未结束,在处理过程结束之前A引用 了C,这时就会用到remark
过程如下:
- 之前C未被引用,这时A引用了C,就会给C加一个写屏障,写屏障的指令会被执行,将C放入一个队列当 中,并将C变为 处理中 状态
- 在并发标记阶段结束以后,重新标记阶段会STW,然后将放在该队列中的对象重新处理,发现有强引用 引用它,就会处理它
JDK 8u20 字符串去重
过程
- 将所有新分配的字符串(底层是char[])放入一个队列
- 当新生代回收时,G1并发检查是否有重复的字符串
- 如果字符串的值一样,就让他们引用同一个字符串对象
- 注意,其与String.intern的区别
- intern关注的是字符串对象
- 字符串去重关注的是char[]
- 在JVM内部,使用了不同的字符串标
优点与缺点
- 节省了大量内存
- 新生代回收时间略微增加,导致略微多占用CPU
JDK 8u40 并发标记类卸载
在并发标记阶段结束以后,就能知道哪些类不再被使用。如果一个类加载器的所有类都不在使用,则卸载它所加载的所有类
JDK 8u60 回收巨型对象
- 一个对象大于region的一半时,就称为巨型对象
- G1不会对巨型对象进行拷贝
- 回收时被优先考虑
- G1会跟踪老年代所有incoming引用,如果老年代incoming引用为0的巨型对象就可以在新生代垃圾回收 时处理掉
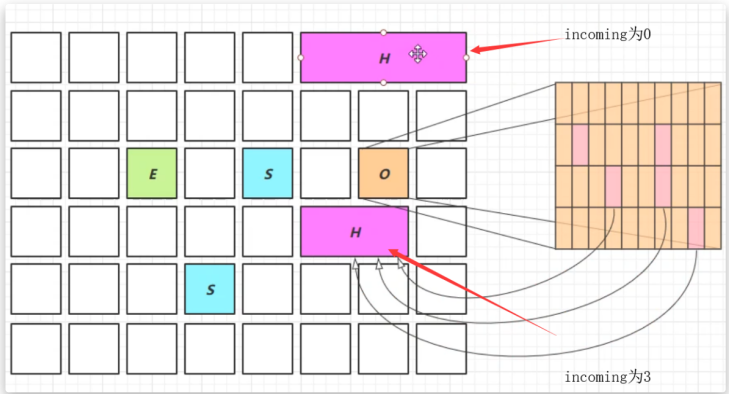
5、GC调优
查看虚拟机参数命令
"F:\JAVA\JDK8.0\bin\java" -XX:+PrintFlagsFinal -version | findstr "GC"可以根据参数去查询具体的信息
调优领域
- 内存
- 锁竞争
- CPU占用
- IO
- GC
确定目标
低延迟/高吞吐量? 选择合适的GC
- CMS G1 ZGC
- ParallelGC
- Zing
最快的GC是不发生GC
首先排除减少因为自身编写的代码而引发的内存问题
查看Full GC前后的内存占用,考虑以下几个问题
- 数据是不是太多?
- 数据表示是否太臃肿
- 对象图
- 对象大小
- 是否存在内存泄漏
新生代调优
- 新生代的特点
- 所有的new操作分配内存都是非常廉价的
- TLAB
- 死亡对象回收零代价
- 大部分对象用过即死(朝生夕死)
- MInor GC 所用时间远小于Full GC
- 所有的new操作分配内存都是非常廉价的
- 新生代内存越大越好么?
- 不是
- 新生代内存太小:频繁触发Minor GC,会STW,会使得吞吐量下降
- 新生代内存太大:老年代内存占比有所降低,会更频繁地触发Full GC。而且触发Minor GC时, 清理新生代所花费的时间会更长
- 新生代内存设置为内容纳 [并发量*(请求-响应)] 的数据为宜
- 不是
幸存区调优
- 幸存区需要能够保存 当前活跃对象+需要晋升的对象
- 晋升阈值配置得当,让长时间存活的对象尽快晋升
老年代调优
四、类加载与字节码技术
结构图
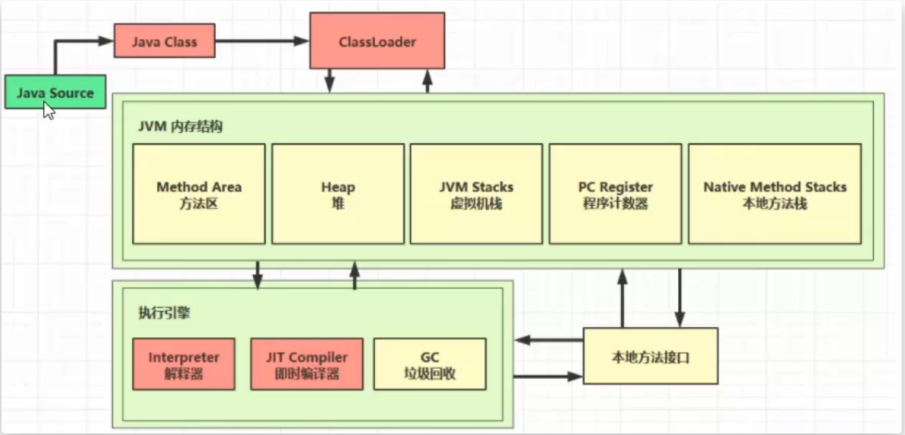
1、类文件结构
首先获得.class字节码文件
方法:
- 在文本文档里写入java代码(文件名与类名一致),将文件类型改为.java
- java终端中,执行javac X:…\XXX.java
根据 JVM 规范,类文件结构如下
u4 magic
u2 minor_version;
u2 major_version;
u2 constant_pool_count;
cp_info constant_pool[constant_pool_count-1];
u2 access_flags;
u2 this_class;
u2 super_class;
u2 interfaces_count;
u2 interfaces[interfaces_count];
u2 fields_count;
field_info fields[fields_count];
u2 methods_count;
method_info methods[methods_count];
u2 attributes_count;
attribute_info attributes[attributes_count];
魔数
u4 magic
对应字节码文件的0~3个字节
0000000 ca fe ba be 00 00 00 34 00 23 0a 00 06 00 15 09
版本
u2 minor_version;
u2 major_version;
0000000 ca fe ba be 00 00 00 34 00 23 0a 00 06 00 15 09
34H = 52,代表JDK8
2、字节码指令
可参考
https://docs.oracle.com/javase/specs/jvms/se8/html/jvms-6.html#jvms-6.5
javap工具
Oracle 提供了 javap 工具来反编译 class 文件
javap -v C:\study\src\com\nyima\JVM\day01\Main.class图解方法执行流程
一、执行的方法代码
public class Demo3_1 {
            public static void main(String[] args) {
                int a = 10;
                int b = Short.MAX_VALUE + 1;
                int c = a + b;
                System.out.println(c);
            }
        }
二、常量池载入运行时常量池
常量池也属于方法区,只不过这里单独提出来了
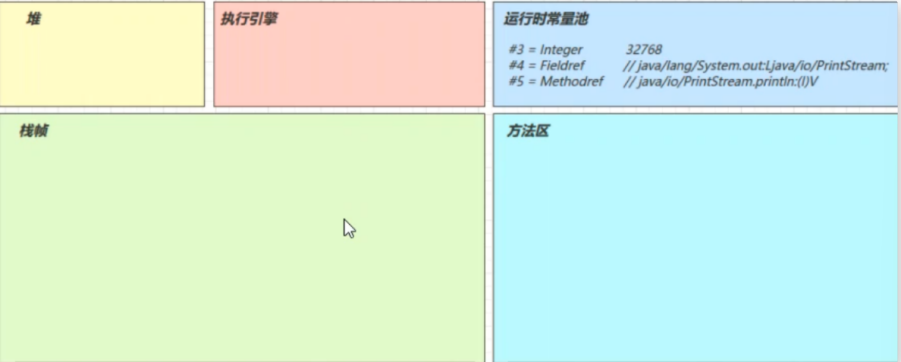
三、方法字节码载入方法区
(stack=2,locals=4) 对应操作数栈有2个空间(每个空间4个字节),局部变量表中有4个槽位
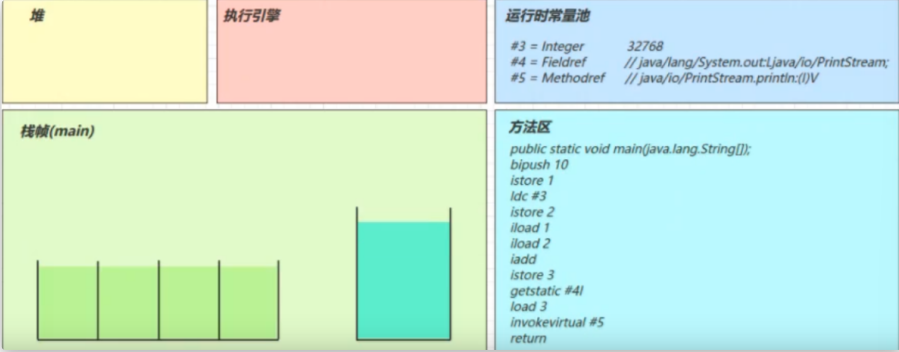
四、执行引擎开始执行字节码
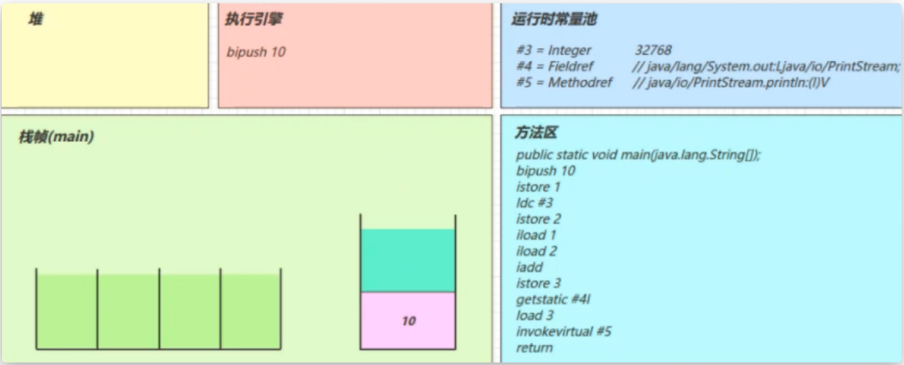
bipush 10
- 将一个 byte 压入操作数栈(其长度会补齐 4 个字节),类似的指令还有
- sipush 将一个 short 压入操作数栈(其长度会补齐 4 个字节)
- ldc 将一个 int 压入操作数栈
- ldc2_w 将一个 long 压入操作数栈(分两次压入,因为 long 是 8 个字节)
- 这里小的数字都是和字节码指令存在一起,超过 short 范围的数字存入了常量池
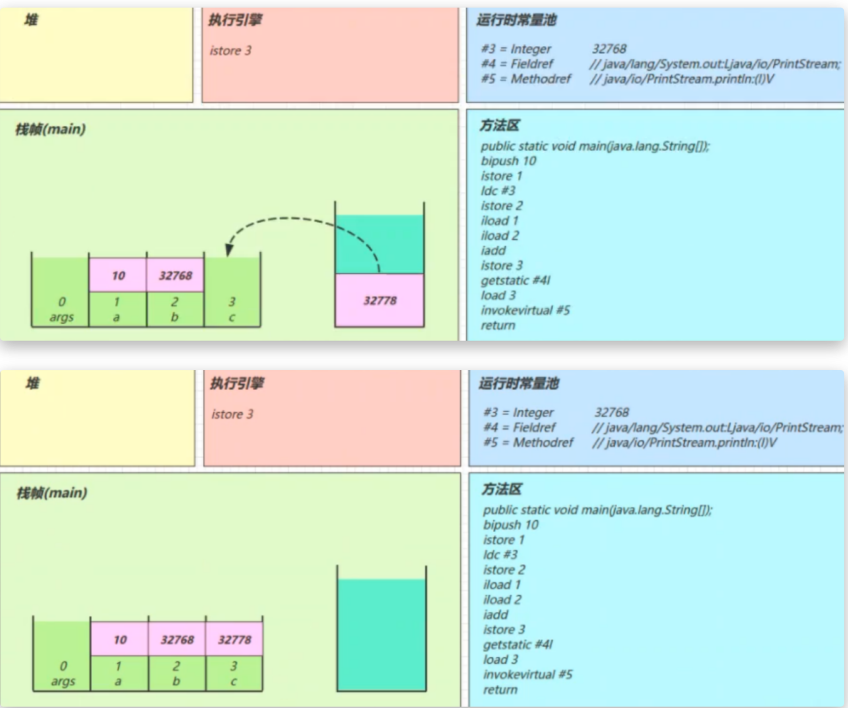
istore 1
将操作数栈栈顶元素弹出,放入局部变量表的slot 1中
对应代码中的
a = 10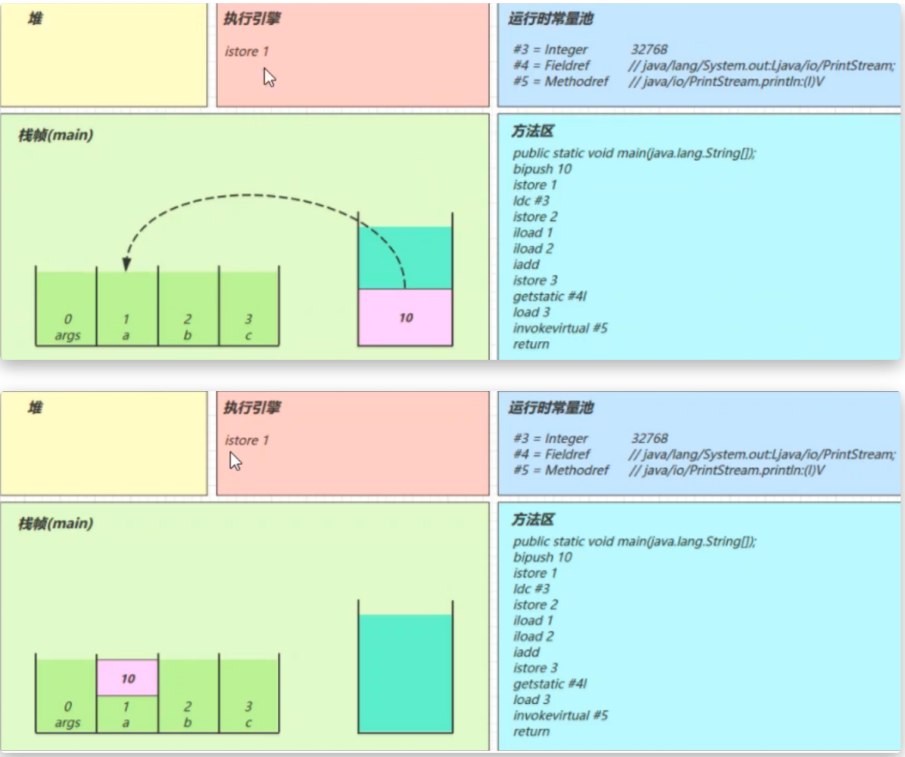
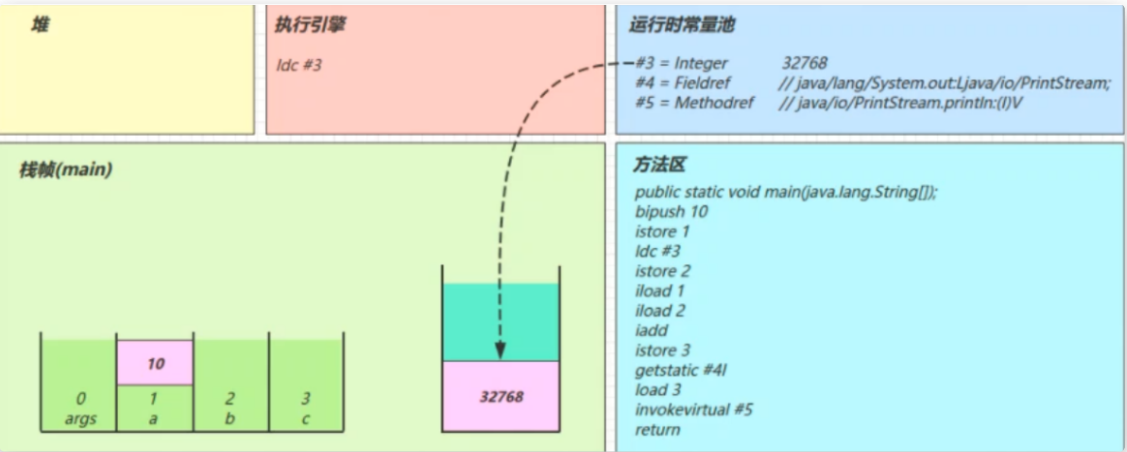
ldc #3
读取运行时常量池中#3,即32768(超过short最大值范围的数会被放到运行时常量池中),将其加载到操作数 栈中
注意: Short.MAX_VALUE 是 32767,所以 32768 = Short.MAX_VALUE + 1 实际是在编译期间计算好的
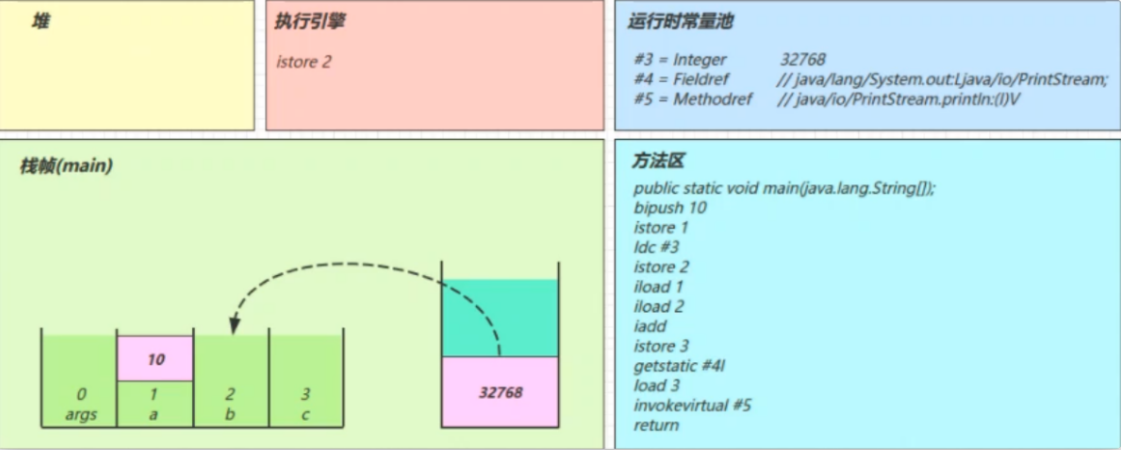
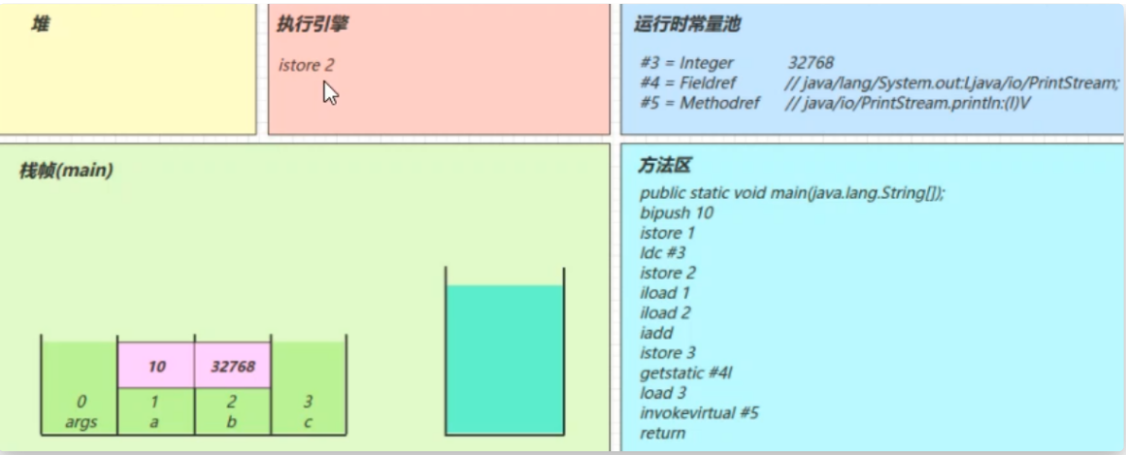
istore 2
将操作数栈中的元素弹出,放到局部变量表的2号位置
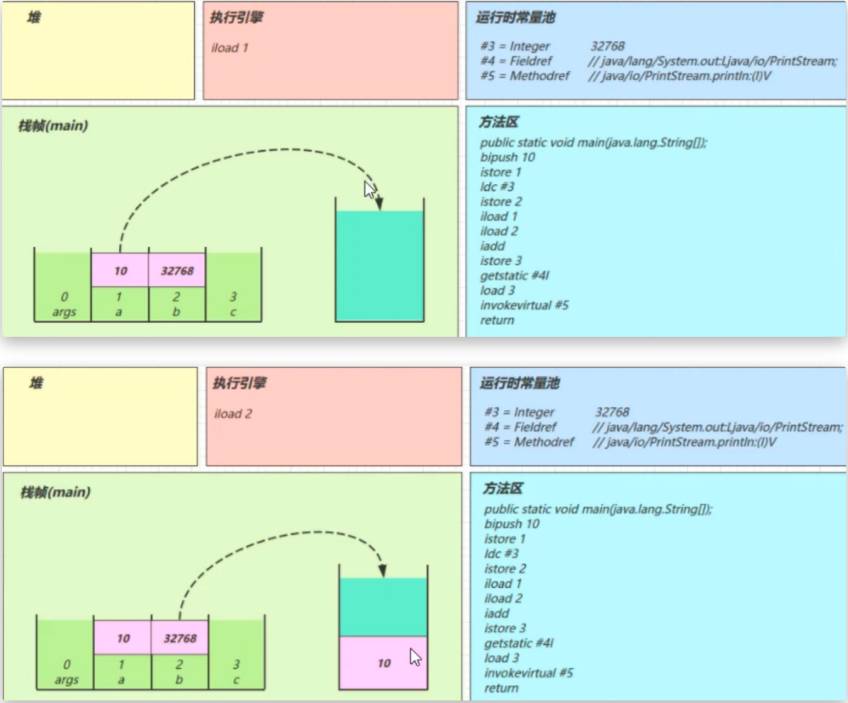
iload1 iload2
将局部变量表中1号位置和2号位置的元素放入操作数栈中
- 因为只能在操作数栈中执行运算操作
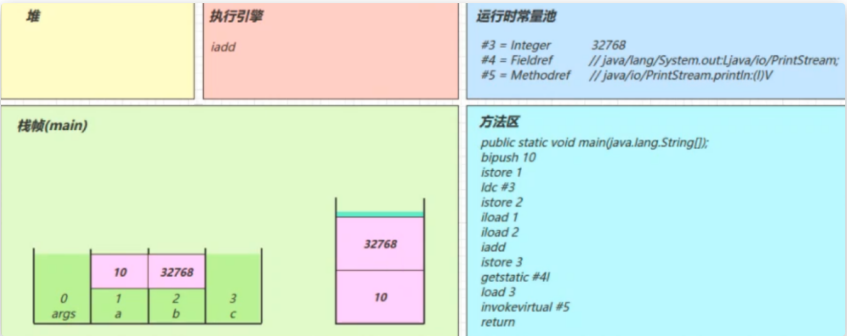
iadd
将操作数栈中的两个元素弹出栈并相加,结果在压入操作数栈中
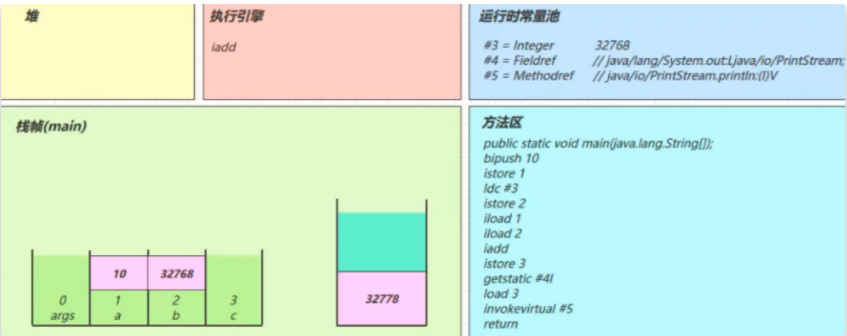
istore 3
将操作数栈中的元素弹出,放入局部变量表的3号位置
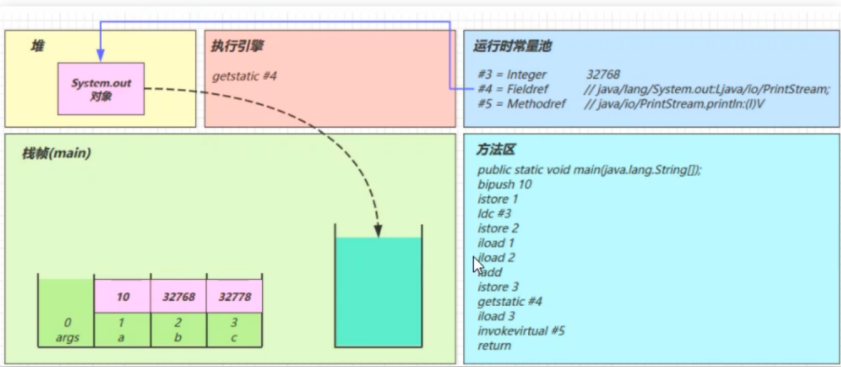
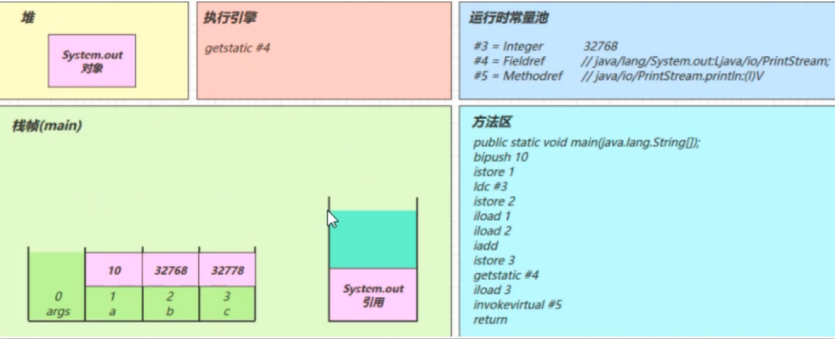
getstatic #4
在运行时常量池中找到#4,发现是一个对象 在堆内存中找到该对象,并将其引用放入操作数栈中
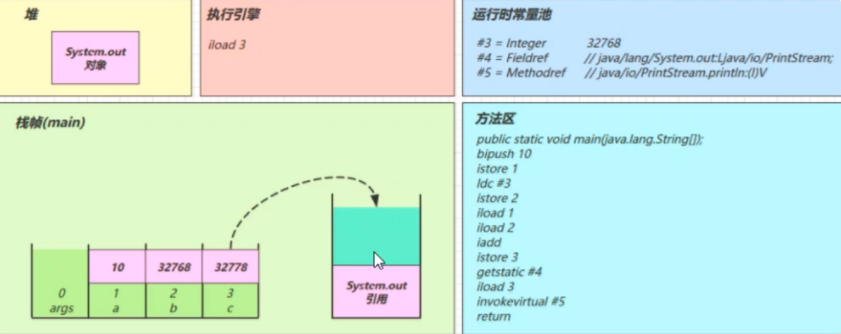
iload 3
将局部变量表中3号位置的元素压入操作数栈中
invokevirtual 5
找到常量池 #5 项,定位到方法区 java/io/PrintStream.println:(I)V 方法
生成新的栈帧(分配 locals、stack等)
传递参数,执行新栈帧中的字节码
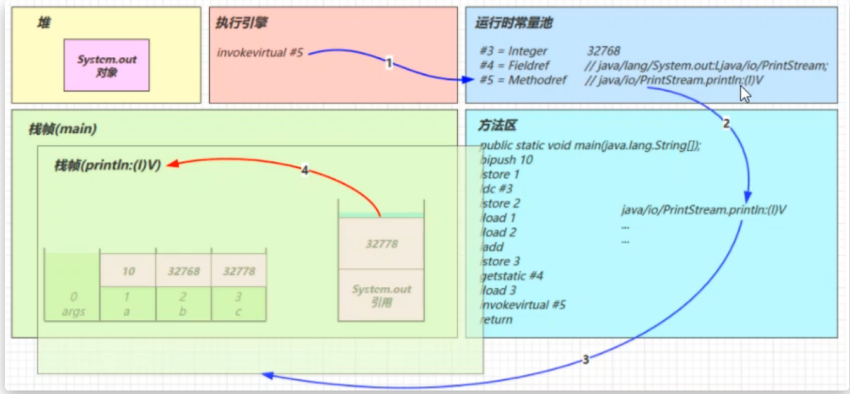
执行完毕,弹出栈帧 清除
main 操作数栈内容
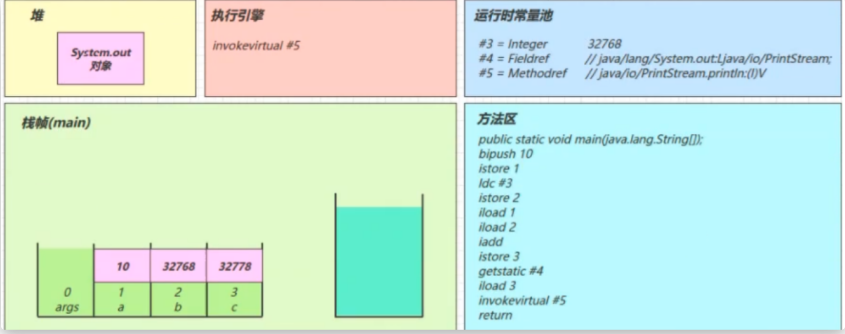
return
完成 main 方法调用,弹出 main 栈帧,程序结束
通过字节码指令来分析问题
代码
public class Demo2 {
            public static void main(String[] args) {
                int i=0;
                int x=0;
                while(i<10) {
                    x = x++;
                    i++;
                }
                System.out.println(x); //接过为0
            }
        }
为什么最终的x结果为0呢? 通过分析字节码指令即可知晓
Code:
 stack=2, locals=3, args_size=1 //操作数栈分配2个空间,局部变量表分配3个空间
 0: iconst_0 //准备一个常数0
 1: istore_1 //将常数0放入局部变量表的1号槽位 i=0
 2: iconst_0 //准备一个常数0
 3: istore_2 //将常数0放入局部变量的2号槽位 x=0
 4: iload_1 //将局部变量表1号槽位的数放入操作数栈中
 5: bipush 10 //将数字10放入操作数栈中,此时操作数栈中有2个数
 7: if_icmpge 21 //比较操作数栈中的两个数,如果下面的数大于上面的数,就跳转到21。这里的比较是将两个数做减法。
 10: iload_2 //将局部变量2号槽位的数放入操作数栈中,放入的值是0
 11: iinc 2, 1 //将局部变量2号槽位的数加1,自增后,槽位中的值为1
 14: istore_2 //将操作数栈中的数放入到局部变量表的2号槽位,2号槽位的值又变为了0
 15: iinc 1, 1 //1号槽位的值自增1
 18: goto 4 //跳转到第4条指令
 21: getstatic #2 // Field java/lang/System.out:Ljava/io/PrintStream;
 24: iload_2
 25: invokevirtual #3 // Method java/io/PrintStream.println:(I)V
 28: return
构造方法
cinit()V
public class Demo3 {
            static int i = 10;
            static {
                i = 20;
            }
            static {
                i = 30;
            }
            public static void main(String[] args) {
                System.out.println(i); //结果为30
            }
}编译器会按从上至下的顺序,收集所有 static 静态代码块和静态成员赋值的代码,合并为一个特殊的方法 cinit()V
stack=1, locals=0, args_size=0
 0: bipush 10
 2: putstatic #3 // Field i:I
 5: bipush 20
 7: putstatic #3 // Field i:I
 10: bipush 30
 12: putstatic #3 // Field i:I
 15: return
init()V
public class Demo4 {
            private String a = "s1";
            {
                b = 20;
            }
            private int b = 10;
            {
                a = "s2";
            }
            public Demo4(String a, int b) {
                this.a = a;
                this.b = b;
            }
            public static void main(String[] args) {
                Demo4 d = new Demo4("s3", 30);
                System.out.println(d.a);
                System.out.println(d.b);
            }
}编译器会按从上至下的顺序,收集所有 {} 代码块和成员变量赋值的代码,形成新的构造方法,但原始构造方法内的代码总是在后
Code:
 stack=2, locals=3, args_size=3
 0: aload_0
 1: invokespecial #1 // Method java/lang/Object."<init>":()V
 4: aload_0
 5: ldc #2 // String s1
 7: putfield #3 // Field a:Ljava/lang/String;
 10: aload_0
 11: bipush 20
 13: putfield #4 // Field b:I
 16: aload_0
 17: bipush 10
 19: putfield #4 // Field b:I
 22: aload_0
 23: ldc #5 // String s2
 25: putfield #3 // Field a:Ljava/lang/String;
 //原始构造方法在最后执行
 28: aload_0
 29: aload_1
 30: putfield #3 // Field a:Ljava/lang/String;
 33: aload_0
 34: iload_2
 35: putfield #4 // Field b:I
 38: return
方法调用
public class Demo5 {
            public Demo5() {
            }
            private void test1() {
            }
            private final void test2() {
            }
            public void test3() {
            }
            public static void test4() {
            }
            public static void main(String[] args) {
                Demo5 demo5 = new Demo5();
                demo5.test1();
                demo5.test2();
                demo5.test3();
                Demo5.test4();
            }
        }
不同方法在调用时,对应的虚拟机指令有所区别
- 私有、构造、被final修饰的方法,在调用时都使用invokespecial指令
- 普通成员方法在调用时,使用invokespecial指令。因为编译期间无法确定该方法的内容,只有在运行期 间才能确定
- 静态方法在调用时使用invokestatic指令
Code:
 stack=2, locals=2, args_size=1
 0: new #2 // class com/nyima/JVM/day5/Demo5
 3: dup
 4: invokespecial #3 // Method "<init>":()V
 7: astore_1
 8: aload_1
 9: invokespecial #4 // Method test1:()V
 12: aload_1
 13: invokespecial #5 // Method test2:()V
 16: aload_1
 17: invokevirtual #6 // Method test3:()V
 20: invokestatic #7 // Method test4:()V
23: return- new 是创建【对象】,给对象分配堆内存,执行成功会将【对象引用】压入操作数栈
- dup 是赋值操作数栈栈顶的内容,本例即为【对象引用】,为什么需要两份引用呢,一个是要配合 invokespecial 调用该对象的构造方法 “init”:()V (会消耗掉栈顶一个引用),另一个要 配合 astore_1 赋值给局部变量
- 终方法(final),私有方法(private),构造方法都是由 invokespecial 指令来调用,属于静态绑定
- 普通成员方法是由 invokevirtual 调用,属于动态绑定,即支持多态成员方法与静态方法调用的另一个区 别是,执行方法前是否需要【对象引用】
多态原理
因为普通成员方法需要在运行时才能确定具体的内容,所以虚拟机需要调用invokevirtual指令
在执行invokevirtual指令时,经历了以下几个步骤
- 先通过栈帧中对象的引用找到对象
- 分析对象头,找到对象实际的Class
- Class结构中有vtable(虚拟方法表)
- 查询
vtable找到方法的具体地址 - 执行方法的字节码
异常处理
try-catch
public class Demo1 {
            public static void main(String[] args) {
                int i = 0;
                try {
                    i = 10;
                }catch (Exception e) {
                    i = 20;
                }
            }
        }
对应字节码指令
Code:
 stack=1, locals=3, args_size=1
 0: iconst_0
 1: istore_1
 2: bipush 10
 4: istore_1
 5: goto 12
 8: astore_2
 9: bipush 20
 11: istore_1
 12: return
 //多出来一个异常表
 Exception table:
 from to target type
2 5 8 Class java/lang/Exception- 可以看到多出来一个 Exception table 的结构,[from, to) 是前闭后开(也就是检测2~4行)的检测范 围,一旦这个范围内的字节码执行出现异常,则通过 type 匹配异常类型,如果一致,进入 target 所指 示行号
- 8行的字节码指令 astore_2 是将异常对象引用存入局部变量表的2号位置(为e)
多个single-catch
public class Demo1 {
            public static void main(String[] args) {
                int i = 0;
                try {
                    i = 10;
                }catch (ArithmeticException e) {
                    i = 20;
                }catch (Exception e) {
                    i = 30;
                }
            }
        }
对应的字节码
Code:
 stack=1, locals=3, args_size=1
 0: iconst_0
 1: istore_1
 2: bipush 10
 4: istore_1
 5: goto 19
 8: astore_2
 9: bipush 20
 11: istore_1
 12: goto 19
 15: astore_2
 16: bipush 30
 18: istore_1
 19: return
 Exception table:
 from to target type
 2 5 8 Class java/lang/ArithmeticException
2 5 15 Class java/lang/Exception- 因为异常出现时,只能进入 Exception table 中一个分支,所以局部变量表 slot 2 位置被共用
finally
public class Demo2 {
            public static void main(String[] args) {
                int i = 0;
                try {
                    i = 10;
                } catch (Exception e) {
                    i = 20;
                } finally {
                    i = 30;
                }
            }
        }
对应字节码
Code:
 stack=1, locals=4, args_size=1
 0: iconst_0
 1: istore_1
 //try块
 2: bipush 10
 4: istore_1
 //try块执行完后,会执行finally
 5: bipush 30
 7: istore_1
 8: goto 27
 //catch块
 11: astore_2 //异常信息放入局部变量表的2号槽位
 12: bipush 20
 14: istore_1
 //catch块执行完后,会执行finally
 15: bipush 30
 17: istore_1
 18: goto 27
 //出现异常,但未被Exception捕获,会抛出其他异常,这时也需要执行finally块中的代码
 21: astore_3
 22: bipush 30
 24: istore_1
 25: aload_3
 26: athrow //抛出异常
 27: return
 Exception table:
 from to target type
 2 5 11 Class java/lang/Exception
 2 5 21 any
 11 15 21 any
可以看到 finally 中的代码被复制了 3 份,分别放入 try 流程,catch 流程以及 catch剩余的异常类型流程
注意:虽然从字节码指令看来,每个块中都有finally块,但是finally块中的代码只会被执行一次
finally中的return
public class Demo3 {
            public static void main(String[] args) {
                int i = Demo3.test();
                //结果为20
                System.out.println(i);
            }
            public static int test() {
                int i;
                try {
                    i = 10;
                    return i;
                } finally {
                    i = 20;
                    return i;
                }
            }
        }
对应字节码
Code:
 stack=1, locals=3, args_size=0
 0: bipush 10
 2: istore_0
 3: iload_0
 4: istore_1 //暂存返回值
 5: bipush 20
 7: istore_0
 8: iload_0
 9: ireturn //ireturn会返回操作数栈顶的整型值20
 //如果出现异常,还是会执行finally块中的内容,没有抛出异常
 10: astore_2
 11: bipush 20
 13: istore_0
 14: iload_0
 15: ireturn //这里没有athrow了,也就是如果在finally块中如果有返回操作的话,且try块中出现异常,会吞掉异常!
 Exception table:
 from to target type
 0 5 10 any
由于 finally 中的 ireturn 被插入了所有可能的流程,因此返回结果肯定以finally的为准
至于字节码中第 2 行,似乎没啥用,且留个伏笔,看下个例子
跟上例中的 finally 相比,发现没有 athrow 了,这告诉我们:如果在 finally 中出现了 return,会吞掉异常
所以不要在finally中进行返回操作
被吞掉的异常
public class Demo3 {
            public static void main(String[] args) {
                int i = Demo3.test();
                //最终结果为20
                System.out.println(i);
            }
            public static int test() {
                int i;
                try {
                    i = 10;
                    //这里应该会抛出异常
                    i = i/0;
                    return i;
                } finally {
                    i = 20;
                    return i;
                }
            }
        }
会发现打印结果为20,并未抛出异常
finally不带return
public class Demo4 {
    public static void main(String[] args) {
        int i = Demo4.test();
        System.out.println(i);
    }
    public static int test() {
        int i = 10;
        try {
            return i;
        } finally {
            i = 20;
        }
    }
}
对应字节码
Code:
 stack=1, locals=3, args_size=0
 0: bipush 10
 2: istore_0 //赋值给i 10
 3: iload_0 //加载到操作数栈顶
 4: istore_1 //加载到局部变量表的1号位置
 5: bipush 20
 7: istore_0 //赋值给i 20
 8: iload_1 //加载局部变量表1号位置的数10到操作数栈
 9: ireturn //返回操作数栈顶元素 10
 10: astore_2
 11: bipush 20
 13: istore_0
 14: aload_2 //加载异常
 15: athrow //抛出异常
 Exception table:
 from to target type
 3 5 10 any
Synchronized
public class Demo5 {
            public static void main(String[] args) {
                int i = 10;
                Lock lock = new Lock();
                synchronized (lock) {
                    System.out.println(i);
                }
            }
        }
class Lock{}
对应字节码
Code:
 stack=2, locals=5, args_size=1
 0: bipush 10
 2: istore_1
 3: new #2 // class com/nyima/JVM/day06/Lock
 6: dup //复制一份,放到操作数栈顶,用于构造函数消耗
 7: invokespecial #3 // Method com/nyima/JVM/day06/Lock."<init>":()V
 10: astore_2 //剩下的一份放到局部变量表的2号位置
 11: aload_2 //加载到操作数栈
 12: dup //复制一份,放到操作数栈,用于加锁时消耗
 13: astore_3 //将操作数栈顶元素弹出,暂存到局部变量表的三号槽位。这时操作数栈中有一份对象的引用
 14: monitorenter //加锁
 //锁住后代码块中的操作
 15: getstatic #4 // Field java/lang/System.out:Ljava/io/PrintStream;
 18: iload_1
 19: invokevirtual #5 // Method java/io/PrintStream.println:(I)V
 //加载局部变量表中三号槽位对象的引用,用于解锁
 22: aload_3
 23: monitorexit //解锁
 24: goto 34
 //异常操作
 27: astore 4
 29: aload_3
 30: monitorexit //解锁
 31: aload 4
 33: athrow
 34: return
 //可以看出,无论何时出现异常,都会跳转到27行,将异常放入局部变量中,并进行解锁操作,然后加载异常并抛出异常。
 Exception table:
 from to target type
 15 24 27 any
 27 31 27 any
3、编译期处理
所谓的 语法糖 ,其实就是指 java 编译器把 .java 源码编译为 .class 字节码的过程中,自动生成和转换**的一 些代码,主要是为了减轻程序员的负担,算是 java 编译器给我们的一个额外福利
注意:以下代码的分析,借助了 javap 工具,idea 的反编译功能,idea 插件 jclasslib 等工具。另外, 编译器转换的结果直接就是 class 字节码,只是为了便于阅读,给出了几乎等价 的 java 源码方式,并不是编译器还会转换出中间的 java 源码,切记。
默认构造函数
public class Candy1 {
        }
经过编译期优化后
public class Candy1 {
           //这个无参构造器是java编译器帮我们加上的
           public Candy1() {
               //即调用父类 Object 的无参构造方法,即调用 java/lang/Object." <init>":()V
               super();
           }
       }
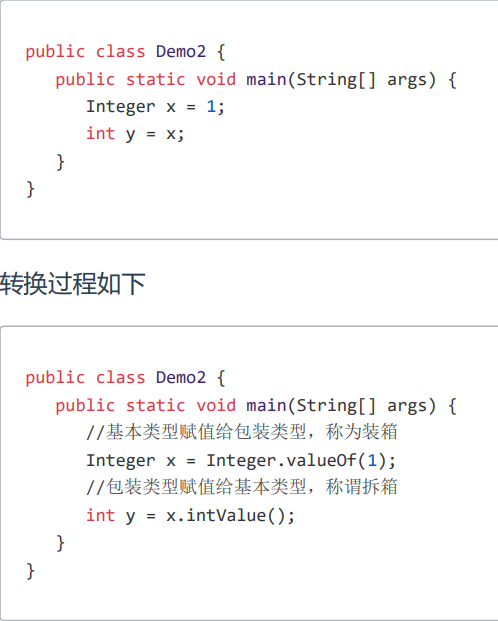
自动拆装箱
基本类型和其包装类型的相互转换过程,称为拆装箱
在JDK 5以后,它们的转换可以在编译期自动完成
泛型集合取值
泛型也是在 JDK 5 开始加入的特性,但 java 在编译泛型代码后会执行 泛型擦除 的动作,即泛型信息在编译为字节码之后就丢失了,实际的类型都当做了 Object 类型来处理:
public class Demo3 {
            public static void main(String[] args) {
                List<Integer> list = new ArrayList<>();
                list.add(10);
                Integer x = list.get(0);
            }
        }
对应字节码
Code:
 stack=2, locals=3, args_size=1
 0: new #2 // class java/util/ArrayList
 3: dup
 4: invokespecial #3 // Method java/util/ArrayList."<init>":()V
 7: astore_1
 8: aload_1
 9: bipush 10
 11: invokestatic #4 // Method java/lang/Integer.valueOf:(I)Ljava/lang/Integer;
 //这里进行了泛型擦除,实际调用的是add(Objcet o)
 14: invokeinterface #5, 2 // InterfaceMethod java/util/List.add:(Ljava/lang/Object;)Z
 19: pop
 20: aload_1
 21: iconst_0
 //这里也进行了泛型擦除,实际调用的是get(Object o)
 22: invokeinterface #6, 2 // InterfaceMethod java/util/List.get:(I)Ljava/lang/Object;
//这里进行了类型转换,将Object转换成了Integer
 27: checkcast #7 // class java/lang/Integer
 30: astore_2
 31: return
所以调用get函数取值时,有一个类型转换的操作
Integer x = (Integer) list.get(0);如果要将返回结果赋值给一个int类型的变量,则还有自动拆箱的操作
int x = (Integer) list.get(0).intValue();可变参数
public class Demo4 {
            public static void foo(String... args) {
                //将args赋值给arr,可以看出String...实际就是String[]
                String[] arr = args;
                System.out.println(arr.length);
            }
            public static void main(String[] args) {
                foo("hello", "world");
            }
        }
可变参数 String… args 其实是一个 String[] args ,从代码中的赋值语句中就可以看出来。 同 样 java 编译 器会在编译期间将上述代码变换为:
public class Demo4 {
            public Demo4 {}

            public static void foo(String[] args) {
                String[] arr = args;
                System.out.println(arr.length);
            }
            public static void main(String[] args) {
                foo(new String[]{"hello", "world"});
            }
}注意,如果调用的是foo(),即未传递参数时,等价代码为foo(new String[]{}),创建了一个空数组,而不是直接传递的null
foreach
public class Demo5 {
            public static void main(String[] args) {
                //数组赋初值的简化写法也是一种语法糖。
                int[] arr = {1, 2, 3, 4, 5};
                for(int x : arr) {
                    System.out.println(x);
                }
            }
        }
编译器会帮我们转换为
public class Demo5 {
            public Demo5 {}
            public static void main(String[] args) {
                int[] arr = new int[]{1, 2, 3, 4, 5};
                for(int i=0; i<arr.length; ++i) {
                    int x = arr[i];
                    System.out.println(x);
                }
            }
        }
如果是集合使用foreach
public class Demo5 {
 public static void main(String[] args) {
 List<Integer> list = Arrays.asList(1, 2, 3, 4, 5);
 for (Integer x : list) {
 System.out.println(x);
 }
 }
}集合要使用foreach,需要该集合类实现了Iterable接口,因为集合的遍历需要用到迭代器Iterator
public class Demo5 {
            public Demo5 {}

            public static void main(String[] args) {
                List<Integer> list = Arrays.asList(1, 2, 3, 4, 5);
                //获得该集合的迭代器
                Iterator<Integer> iterator = list.iterator();
                while(iterator.hasNext()) {
                    Integer x = iterator.next();
                    System.out.println(x);
                }
            }
        }
switch字符串
public class Demo6 {
           public static void main(String[] args) {
               String str = "hello";
               switch (str) {
                   case "hello" :
                       System.out.println("h");
                       break;
                   case "world" :
                       System.out.println("w");
                       break;
                   default:
                       break;
               }
           }
       }
在编译器中执行的操作
public class Demo6 {
           public Demo6() {

           }
           public static void main(String[] args) {
               String str = "hello";
               int x = -1;
               //通过字符串的hashCode+value来判断是否匹配
               switch (str.hashCode()) {
                   //hello的hashCode
                   case 99162322 :
                       //再次比较,因为字符串的hashCode有可能相等
                       if(str.equals("hello")) {
                           x = 0;
                       }
                       break;
                   //world的hashCode
                   case 11331880 :
                       if(str.equals("world")) {
                           x = 1;
                       }
                       break;
                   default:
                       break;
               }
               //用第二个switch在进行输出判断
               switch (x) {
                   case 0:
                       System.out.println("h");
                       break;
                   case 1:
                       System.out.println("w");
                       break;
                   default:
                       break;
               }
           }
       }
过程说明:
- 在编译期间,单个的switch被分为了两个
- 第一个用来匹配字符串,并给x赋值
- 字符串的匹配用到了字符串的hashCode,还用到了equals方法
- 使用hashCode是为了提高比较效率,使用equals是防止有hashCode冲突(如BM和C.)
- 第二个用来根据x的值来决定输出语句
- 第一个用来匹配字符串,并给x赋值
switch枚举
public class Demo7 {
           public static void main(String[] args) {
               SEX sex = SEX.MALE;
               switch (sex) {
                   case MALE:
                       System.out.println("man");
                       break;
                   case FEMALE:
                       System.out.println("woman");
                       break;
                   default:
                       break;
               }
           }
       }
       enum SEX {
           MALE, FEMALE;
       }
编译器中执行的代码如下
public class Demo7 {
           /**
            * 定义一个合成类(仅 jvm 使用,对我们不可见)
            * 用来映射枚举的 ordinal 与数组元素的关系
            * 枚举的 ordinal 表示枚举对象的序号,从 0 开始
            * 即 MALE 的 ordinal()=0,FEMALE 的 ordinal()=1
            */
           static class $MAP {
               //数组大小即为枚举元素个数,里面存放了case用于比较的数字
               static int[] map = new int[2];
               static {
                   //ordinal即枚举元素对应所在的位置,MALE为0,FEMALE为1
                   map[SEX.MALE.ordinal()] = 1;
                   map[SEX.FEMALE.ordinal()] = 2;
               }
           }
           public static void main(String[] args) {
               SEX sex = SEX.MALE;
               //将对应位置枚举元素的值赋给x,用于case操作
               int x = $MAP.map[sex.ordinal()];
               switch (x) {
                   case 1:
                       System.out.println("man");
                       break;
                   case 2:
                       System.out.println("woman");
                       break;
                   default:
                       break;
               }
           }
       }
       enum SEX {
           MALE, FEMALE;
       }
枚举类
enum SEX {
 MALE, FEMALE;
}
转换后的代码
public final class Sex extends Enum<Sex> {
           //对应枚举类中的元素
           public static final Sex MALE;
           public static final Sex FEMALE;
           private static final Sex[] $VALUES;

           static {
               //调用构造函数,传入枚举元素的值及ordinal
               MALE = new Sex("MALE", 0);
               FEMALE = new Sex("FEMALE", 1);
               $VALUES = new Sex[]{MALE, FEMALE};
           }

           //调用父类中的方法
           private Sex(String name, int ordinal) {
               super(name, ordinal);
           }

           public static Sex[] values() {
               return $VALUES.clone();
           }
           public static Sex valueOf(String name) {
               return Enum.valueOf(Sex.class, name);
           }

       }
匿名内部类
public class Demo8 {
            public static void main(String[] args) {
                Runnable runnable = new Runnable() {
                    @Override
                    public void run() {
                        System.out.println("running...");
                    }
                };
            }
        }
转换后的代码
public class Demo8 {
           public static void main(String[] args) {
               //用额外创建的类来创建匿名内部类对象
               Runnable runnable = new Demo8$1();
           }
       }
       //创建了一个额外的类,实现了Runnable接口
       final class Demo8$1 implements Runnable {
           public Demo8$1() {}
           @Override
           public void run() {
               System.out.println("running...");
           }
}如果匿名内部类中引用了局部变量
public class Demo8 {
          public static void main(String[] args) {
              int x = 1;
              Runnable runnable = new Runnable() {
                  @Override
                  public void run() {
                      System.out.println(x);
                  }
              };
          }
      }
转化后代码
public class Demo8 {
            public static void main(String[] args) {
                int x = 1;
                Runnable runnable = new Runnable() {
                    @Override
                    public void run() {
                        System.out.println(x);
                    }
                };
            }
        }
        final class Demo8$1 implements Runnable {
            //多创建了一个变量
            int val$x;
            //变为了有参构造器
            public Demo8$1(int x) {
                this.val$x = x;
            }
            @Override
            public void run() {
                System.out.println(val$x);
            }
        }
4、类加载阶段
加载
- 将类的字节码载入方法区(1.8后为元空间,在本地内存中)中,内部采用 C++ 的 instanceKlass 描述 java 类,它的重要 field 有:
- _java_mirror 即 java 的类镜像,例如对 String 来说,它的镜像类就是 String.class,作用是把 klass 暴露给 java 使用
- _super 即父类
- _fields 即成员变量
- _methods 即方法
- _constants 即常量池
- _class_loader 即类加载器
- _vtable 虚方法表
- _itable 接口方法
- 如果这个类还有父类没有加载,先加载父类
- 加载和链接可能是交替运行的
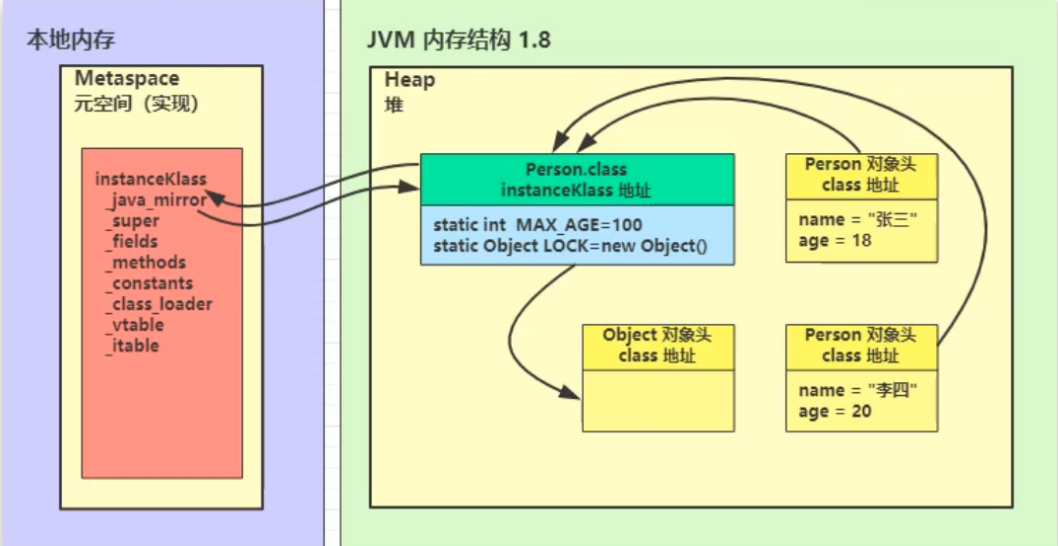
- instanceKlass保存在方法区。JDK 8以后,方法区位于元空间中,而元空间又位于本地内存中
- _java_mirror则是保存在堆内存中
- InstanceKlass和*.class(JAVA镜像类)互相保存了对方的地址
- 类的对象在对象头中保存了*.class的地址。让对象可以通过其找到方法区中的instanceKlass,从而获取 类的各种信息
链接
验证
验证类是否符合JVM规范,安全性检查
准备
为 static 变量分配空间,设置默认值
- static变量在JDK 7以前是存储与instanceKlass末尾。但在JDK 7以后就存储在_java_mirror末尾了
- static变量在分配空间和赋值是在两个阶段完成的。分配空间在准备阶段完成,赋值在初始化阶段完成
- 如果 static 变量是 final 的基本类型,以及字符串常量,那么编译阶段值就确定了,赋值在准备阶段完成
- 如果 static 变量是 final 的,但属于引用类型,那么赋值也会在初始化阶段完成
解析
- HSDB的使用
初始化
初始化阶段就是执行类构造器clinit()方法的过程,虚拟机会保证这个类的『构造方法』的线程安全
clinit()方法是由编译器自动收集类中的所有类变量的赋值动作和静态语句块(static{}块)中的语句合并产生的
注意:编译器收集的顺序是由语句在源文件中出现的顺序决定的,静态语句块中只能访问到定义在静态语句块之前的 变量,定义在它之后的变量,在前面的静态语句块可以赋值,但是不能访问,如
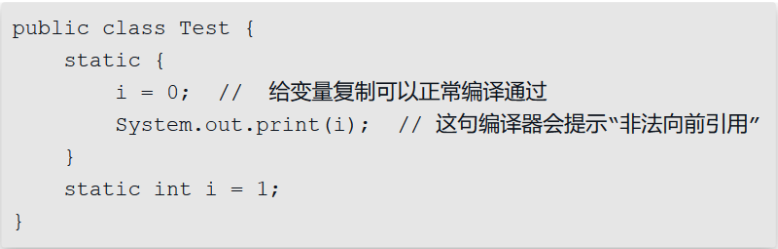
发生时机
类的初始化的懒惰的,以下情况会初始化
- main 方法所在的类,总会被首先初始化
- 首次访问这个类的静态变量或静态方法时
- 子类初始化,如果父类还没初始化,会引发
- 子类访问父类的静态变量,只会触发父类的初始化
- Class.forName
- new 会导致初始化
以下情况不会初始化
- 访问类的 static final 静态常量(基本类型和字符串)
- 类对象.class 不会触发初始化
- 创建该类对象的数组
- 类加载器的.loadClass方法
- Class.forNamed的参数2为false时
验证类是否被初始化,可以看改类的静态代码块是否被执行
5、类加载器
Java虚拟机设计团队有意把类加载阶段中的“通过一个类的全限定名来获取描述该类的二进制字节流”这个动 作放到Java虚拟机外部去实现,以便让应用程序自己决定如何去获取所需的类。实现这个动作的代码被称 为“类加载器”(ClassLoader)
类与类加载器
类加载器虽然只用于实现类的加载动作,但它在Java程序中起到的作用却远超类加载阶段
对于任意一个类,都必须由加载它的类加载器和这个类本身一起共同确立其在Java虚拟机中的唯一性,每一个 类加载器,都拥有一个独立的类名称空间。这句话可以表达得更通俗一些:比较两个类是否“相等”,只有在 这两个类是由同一个类加载器加载的前提下才有意义,否则,即使这两个类来源于同一个Class文件,被同一 个Java虚拟机加载,只要加载它们的类加载器不同,那这两个类就必定不相等
以JDK 8为例
| 名称 | 加载的类 | 说明 |
|---|---|---|
| Bootstrap ClassLoader(启动类加载器) | JAVA_HOME/jre/lib | 无法直接访问 |
| Extension ClassLoader (拓展类加载器) | JAVA_HOME/jre/lib/ext | 上级为Bootstrap,显示为 null |
| Application ClassLoader (应用程序类加载器) | classpath | 上级为Extension |
| 自定义类加载器 | 自定义 | 上级为Application |
启动类加载器
可通过在控制台输入指令,使得类被启动类加器加载
拓展类加载
如果classpath和JAVA_HOME/jre/lib/ext 下有同名类,加载时会使用拓展类加载器加载。当应用程序类加载 器发现拓展类加载器已将该同名类加载过了,则不会再次加载
双亲委派模式(经典面试题)
双亲委派模式,即调用类加载器ClassLoader 的 loadClass 方法时,查找类的规则
loadClass源码
protected Class<?> loadClass(String name, boolean resolve) throws ClassNotFoundException
        {
            synchronized (getClassLoadingLock(name)) {
                // 首先查找该类是否已经被该类加载器加载过了
                Class<?> c = findLoadedClass(name);
                //如果没有被加载过
                if (c == null) {
                    long t0 = System.nanoTime();
                    try {
                        //看是否被它的上级加载器加载过了 Extension的上级是Bootstarp,但它显示为null
                        if (parent != null) {
                            c = parent.loadClass(name, false);
                        } else {
                            //看是否被启动类加载器加载过
                            c = findBootstrapClassOrNull(name);
                        }
                    } catch (ClassNotFoundException e) {
                        // ClassNotFoundException thrown if class not found
                        // from the non-null parent class loader
                        //捕获异常,但不做任何处理
                    }
                    if (c == null) {
                        //如果还是没有找到,先让拓展类加载器调用findClass方法去找到该类,如果还是没找到,就抛出异常
                        //然后让应用类加载器去找classpath下找该类
                        long t1 = System.nanoTime();
                        c = findClass(name);
                        // 记录时间
                        sun.misc.PerfCounter.getParentDelegationTime().addTime(t1 - t0);
                        sun.misc.PerfCounter.getFindClassTime().addElapsedTimeFrom(t1);
                        sun.misc.PerfCounter.getFindClasses().increment();
                    }
                }
                if (resolve) {
                    resolveClass(c);
                }
                return c;
            }
}总结:先由下到上询问,后由上到下加载
自定义类加载器
使用场景
- 想加载非 classpath 随意路径中的类文件
- 通过接口来使用实现,希望解耦时,常用在框架设计
- 这些类希望予以隔离,不同应用的同名类都可以加载,不冲突,常见于 tomcat 容器
步骤
继承ClassLoader父类
要遵从双亲委派机制,重写 findClass 方法
不是重写loadClass方法,否则不会走双亲委派机制
读取类文件的字节码
调用父类的 defineClass 方法来加载类
使用者调用该类加载器的 loadClass 方法
破坏双亲委派模式
双亲委派模型的第一次“被破坏”其实发生在双亲委派模型出现之前——即JDK1.2面世以前的“远 古”时代
建议用户重写findClass()方法,在类加载器中的loadClass()方法中也会调用该方法
双亲委派模型的第二次“被破坏”是由这个模型自身的缺陷导致的
如果有基础类型又要调用回用户的代码,此时也会破坏双亲委派模式
双亲委派模型的第三次“被破坏”是由于用户对程序动态性的追求而导致的
这里所说的“动态性”指的是一些非常“热”门的名词:代码热替换(Hot Swap)、模块热部署 (Hot Deployment)等
6、运行期优化
分层编译
JVM 将执行状态分成了 5 个层次:
- 0层:解释执行,用解释器将字节码翻译为机器码
- 1层:使用 C1 即时编译器编译执行(不带 profiling)
- 2层:使用 C1 即时编译器编译执行(带基本的profiling)
- 3层:使用 C1 即时编译器编译执行(带完全的profiling)
- 4层:使用 C2 即时编译器编译执行
profiling 是指在运行过程中收集一些程序执行状态的数据,例如【方法的调用次数】,【循环的 回边次数】 等
即时编译器(JIT)与解释器的区别
- 解释器
- 将字节码解释为机器码,下次即使遇到相同的字节码,仍会执行重复的解释
- 是将字节码解释为针对所有平台都通用的机器码
- 即时编译器
- 将一些字节码编译为机器码,并存入 Code Cache,下次遇到相同的代码,直接执行,无需再编译
- 根据平台类型,生成平台特定的机器码
对于大部分的不常用的代码,我们无需耗费时间将其编译成机器码,而是采取解释执行的方式运行;另一方 面,对于仅占据小部分的热点代码,我们则可以将其编译成机器码,以达到理想的运行速度。 执行效率上简 单比较一下 Interpreter < C1 < C2,总的目标是发现热点代码(hotspot名称的由 来),并优化这些热点代码
逃逸分析
逃逸分析(Escape Analysis)简单来讲就是,Java Hotspot 虚拟机可以分析新创建对象的使用范围,并决定 是否在 Java 堆上分配内存的一项技术
逃逸分析的 JVM 参数如下:
- 开启逃逸分析:
-XX:+DoEscapeAnalysis - 关闭逃逸分析:
-XX:-DoEscapeAnalysis - 显示分析结果:
-XX:+PrintEscapeAnalysis
逃逸分析技术在 Java SE 6u23+ 开始支持,并默认设置为启用状态,可以不用额外加这个参数
对象逃逸状态
- 即一个对象的作用范围逃出了当前方法或者当前线程,有以下几种场景:
- 对象是一个静态变量
- 对象是一个已经发生逃逸的对象
- 对象作为当前方法的返回值
参数逃逸(ArgEscape)
- 即一个对象被作为方法参数传递或者被参数引用,但在调用过程中不会发生全局逃逸,这个状态是通过被 调方法的字节码确定的
没有逃逸
- 即一个对象被作为方法参数传递或者被参数引用,但在调用过程中不会发生全局逃逸,这个状态是通过被 调方法的字节码确定的
逃逸分析优化
针对上面第三点,当一个对象没有逃逸时,可以得到以下几个虚拟机的优化:
1、锁消除
我们知道线程同步锁是非常牺牲性能的,当编译器确定当前对象只有当前线程使用,那么就会移除该对象的同步锁
例如,StringBuffer 和 Vector 都是用 synchronized 修饰线程安全的,但大部分情况下,它们都只是在当前 线程中用到,这样编译器就会优化移除掉这些锁操作
锁消除的 JVM 参数如下:
- 开启锁消除:
-XX:+EliminateLocks - 关闭锁消除:
-XX:-EliminateLocks
锁消除在 JDK8 中都是默认开启的,并且锁消除都要建立在逃逸分析的基础上
2、标量替换
首先要明白标量和聚合量,基础类型和对象的引用可以理解为标量,它们不能被进一步分解。而能被进一步分 解的量就是聚合量,比如:对象
对象是聚合量,它又可以被进一步分解成标量,将其成员变量分解为分散的变量,这就叫做标量替换。
这样,如果一个对象没有发生逃逸,那压根就不用创建它,只会在栈或者寄存器上创建它用到的成员标量,节 省了内存空间,也提升了应用程序性能
标量替换的 JVM 参数如下:
- 开启标量替换:
-XX:+EliminateAllocations - 关闭标量替换:
-XX:-EliminateAllocations - 显示标量替换详情:
-XX:+PrintEliminateAllocations
标量替换同样在 JDK8 中都是默认开启的,并且都要建立在逃逸分析的基础上
三、栈上分配
当对象没有发生逃逸时,该对象就可以通过标量替换分解成成员标量分配在栈内存中,和方法的生命周期一 致,随着栈帧出栈时销毁,减少了 GC 压力,提高了应用程序性能
方法内联
1、内联函数
内联函数就是在程序编译时,编译器将程序中出现的内联函数的调用表达式用内联函数的函数体来直接进行替换
2、JVM内联函数
C++是否为内联函数由自己决定,Java由编译器决定。Java不支持直接声明为内联函数的,如果想让他内 联,你只能够向编译器提出请求: 关键字final修饰 用来指明那个函数是希望被JVM内联的,如
public final void doSomething() {
           // to do something
       }
总的来说,一般的函数都不会被当做内联函数,只有声明了final后,编译器才会考虑是不是要把你的函数变成内联函数
JVM内建有许多运行时优化。首先短方法更利于JVM推断。流程更明显,作用域更短,副作用也更明显。如果是长方法JVM可能直接就跪了。
第二个原因则更重要:方法内联
如果JVM监测到一些小方法被频繁的执行,它会把方法的调用替换成方法体本身,如:
private int add4(int x1, int x2, int x3, int x4) {
       //这里调用了add2方法
           return add2(x1, x2) + add2(x3, x4);
       }
       private int add2(int x1, int x2) {
           return x1 + x2;
       }
方法调用被替换后
private int add4(int x1, int x2, int x3, int x4) {
           //被替换为了方法本身
           return x1 + x2 + x3 + x4;
       }
反射优化
public class Reflect1 {
           public static void foo() {
               System.out.println("foo...");
           }
           public static void main(String[] args) throws NoSuchMethodException, InvocationTargetException, IllegalAccessException{
           Method foo = Demo3.class.getMethod("foo");
                for(int i = 0; i<=16; i++) {
                    foo.invoke(null);
                }
           }
       }
foo.invoke 前面 0 ~ 15 次调用使用的是 MethodAccessor 的 NativeMethodAccessorImpl 实现, invoke方法源码
@CallerSensitive
      public Object invoke(Object obj, Object... args)throws IllegalAccessException, IllegalArgumentException,
              InvocationTargetException
      {
          if (!override) {
              if (!Reflection.quickCheckMemberAccess(clazz, modifiers)) {
                  Class<?> caller = Reflection.getCallerClass();
                  checkAccess(caller, clazz, obj, modifiers);
              }
          }
          //MethodAccessor是一个接口,有3个实现类,其中有一个是抽象类
          MethodAccessor ma = methodAccessor; // read volatile
          if (ma == null) {
              ma = acquireMethodAccessor();
          }
          return ma.invoke(obj, args);
      }
会由DelegatingMehodAccessorImpl去调用NativeMethodAccessorImpl
一开始if条件不满足,就会调用本地方法invoke0
随着numInvocation的增大,当它大于ReflectionFactory.inflationThreshold的值16时,就会本地方法访问器替换为一个运行时动态生成的访问器,来提高效率
这时会从反射调用变为正常调用,即直接调用 Reflect1.foo()
ps:
以上就是对JVM的详细介绍了,
如果这篇文章对您有帮助,可以在下方进行留言;
下面的赏是对我最大的鼓励。
您的鼓励就是我最大的动力!
资料参考于课本,csdn开发者论坛,博客园开发者论坛…
转载请注明出处https://lil-sum.github.io/, 感谢配合.